為什麼一個新站,兩週就被 AI 搜尋大量引用——一次真實的 crawl→index→cite 拆解
一個 2026-09-20 上線的新站,兩週內 Google 曝光上升,並在一次 Perplexity 引用探針裡被大量取源、排第一。但沒有對照組,拆不開原因;只能提出與數據一致的假設:掛對母域+把事實做成機器可驗的來源。
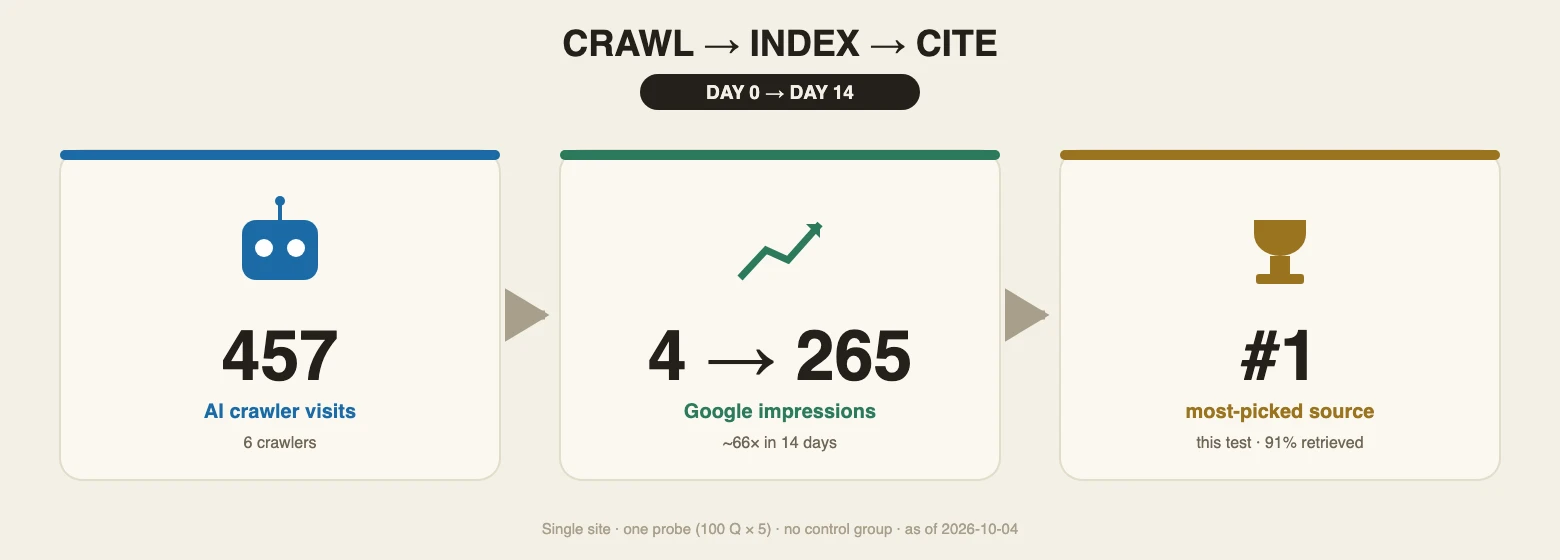
一個 2026-09-20 才上線的站,Google 曝光在兩週內往上走;另一次 Perplexity 引用探針,則把它大量抓為來源、排在第一。為什麼這麼快?我沒有對照組,也沒有做逐項移除測試,還拆不開原因。
目前能提出的是一個與數據一致的假設:網站掛在 AI 爬蟲早已常態造訪的母域下,事實又整理成機器容易取用、可以回溯核對的來源。母域可能讓它較快被看見,證據結構可能讓它較容易被選中。兩者各出了多少力,這次量測回答不了。
這篇交代數字,以及數字容許我們推到哪裡。AEO 的概念與 SEO 差異,見《AEO 不是 SEO》;建置做法,見《個人 IDA 方法論》。
三個節點的真實痕跡
這是我自己的事實頁 tklin.washinmura.jp,掛在已有數年歷史的母域 washinmura.jp 下,2026-09-20 上線。母域原本就有 AI 爬蟲流量。網站在 crawl(被抓)、index(被收錄)、cite(被引用)三段,留下的是三種不同訊號。
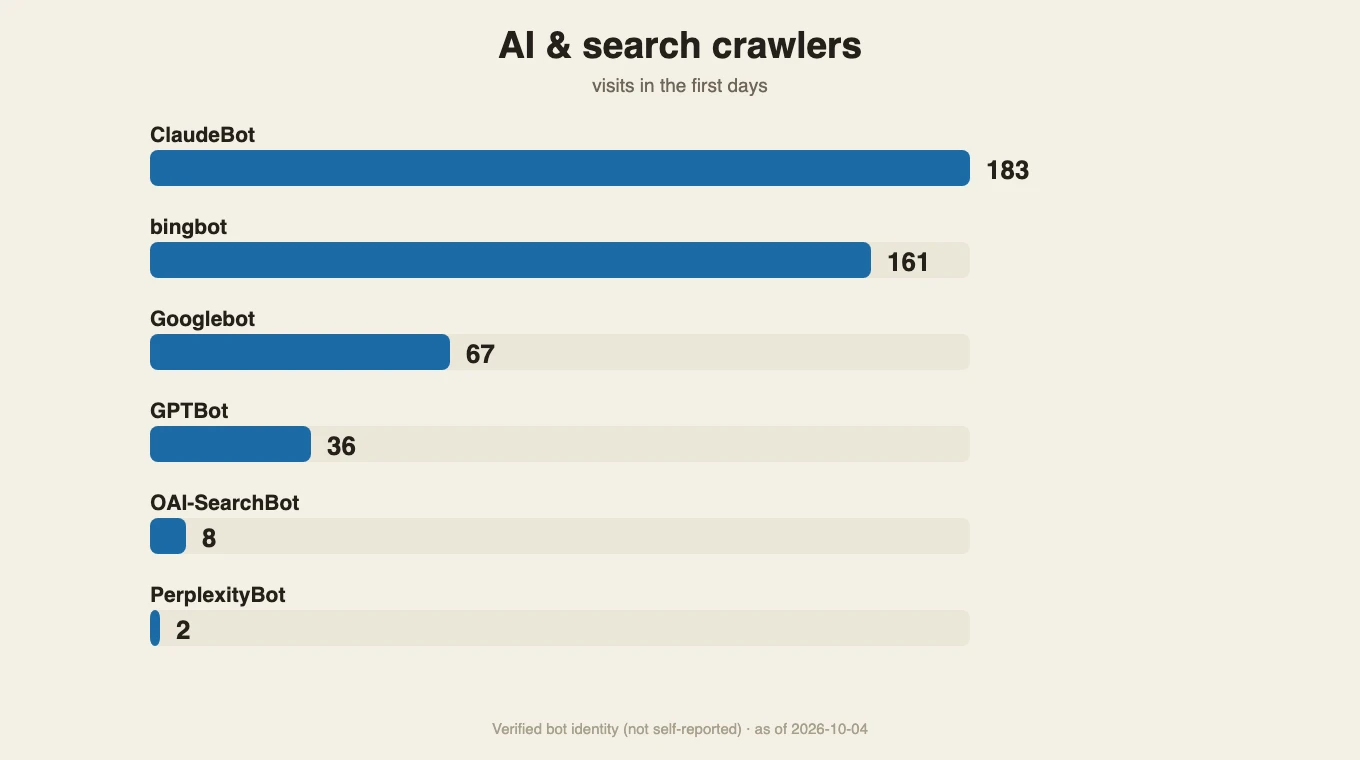
Crawl。 上線數天內,Cloudflare「認證爬蟲身分」記到的次數是:ClaudeBot 183、bingbot 161、Googlebot 67、GPTBot 36、OAI-SearchBot 8、PerplexityBot 2。這些是經驗證的機器人身分,不是 User-Agent 自稱。六種爬蟲都來過,造訪量卻差得很遠。
Index。 Google Search Console 的曝光在兩週內依序走到 4 → 32 → 89 → 171 → 265。GSC 曝光上升,證明搜尋可見度在漲;它不等於已收錄頁數。
Cite。 我用 Perplexity 的 Agent API 跑了一次 100 題 × 5 個模型後端的引用探針。5 個後端全部走 Perplexity 自己的網頁搜尋。這次量的是 Perplexity 搜尋會不會抓這個站當來源,不是五家獨立 AI 各自判斷。
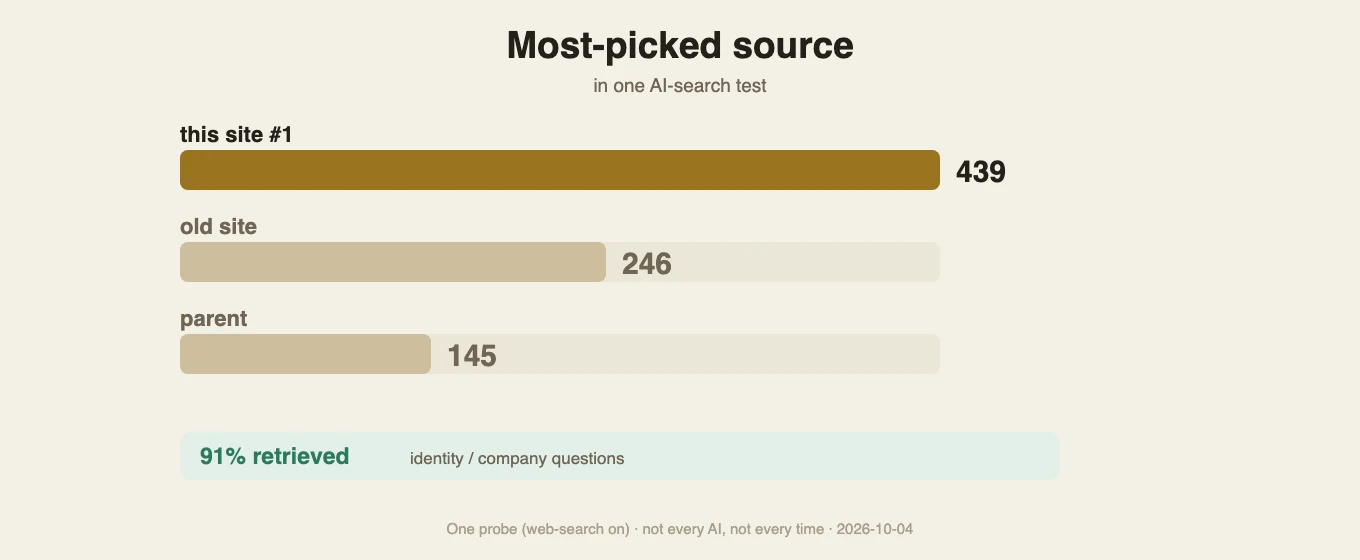
結果是檢索成功率 retrieved 91%(身分/公司題)。取源次數:tklin.washinmura.jp 439(第一)、tklin.me 246、washinmura.jp 145。5 個受測後端都取用了新站;不點名描述題 19/20 指向他。這是 Perplexity 搜尋大量取用它的強訊號,不能改寫成「一般對話裡每家 AI 都穩定首引它」。
時間也要說準。「兩週」是上線後觀察 GSC 曝光的窗口。引用探針另跑一次;DATA 來源沒有記下確切執行日期,因此不能說引用正好發生在那兩週內。能確定的是:兩週內搜尋可見度上升,而探針那一次,Perplexity 搜尋已大量抓它作來源。
為什麼抓得快,為什麼被選為來源
先看爬取。母域既有流量,是一個可能原因。 washinmura.jp 有多年歷史,AI 爬蟲原本就常來;子網域搭上這條流量管道,可能少了全新域名的冷啟動等待。但這只支持「搭上既有爬蟲流量」的說法,不能宣稱母域把「權重」繼承給子站。數據沒有證明繼承。
技術設定可能也幫了忙。 robots.txt 全放行,HTTP 標頭設 X-Robots-Tag: all,sitemap.xml 列出站內頁面,IndexNow 主動推播更新。爬蟲來時進得去,也有機會收到新頁面的通知。母域與技術各貢獻多少,沒有對照實驗可拆。
接著是一個看似矛盾的數字:PerplexityBot 只來 2 次,這個站卻在探針裡被取源 439 次。合理推論是,Perplexity 這一次的即時檢索搭了通用搜尋索引的便車,並非只靠自家爬蟲建庫。Perplexity 作為 meta-search,會調用 Bing/Google 等搜尋結果,再交給模型整合;通用索引先收進頁面,它就可能找得到。
這個推論只適用於 Perplexity 的這一次探針。Cloudflare 記到的爬蟲請求,與 Agent API 檢索時的取源,也不是同一個指標,不能拿 2 次直接推算 439 次。更不能把這個觀察擴大成「專用爬蟲不重要」:同一份紀錄裡,ClaudeBot 來了 183 次、GPTBot 36 次;有些 AI 檢索系統,例如 OpenAI 原生的檢索環境,相當依賴自家專用爬蟲抓取建庫。通用搜尋引擎與專用爬蟲,兩邊都別擋。
至於收錄之後為何被選中,我認為證據結構可能有作用。這是機制假設;我沒有做逐項移除(ablation)測試,不能把它寫成已證因果。
schema.org 的 JSON-LD 用單一 @id 把 Person 與 Organization 綁到同一個正規身分,理論上能減少同名混淆。anchors.json 44 條第三方來源,每條附 Wayback 快照與 sha256,方便逐條回溯、核對。sha256 只能驗內容是否一致、是否被竄改,不能驗內容本身為真。llms.txt、llms-full.txt、brief.txt 與四語版本,則提供機器容易剖析的純文字事實,也增加不同語言問句的匹配機會。
這些安排可能共同影響了身分題的 91% 檢索率,以及不點名題 19/20 的結果。哪一項有效、各占多少,目前沒有證據能拆開。
哪些是方法,哪些是運氣
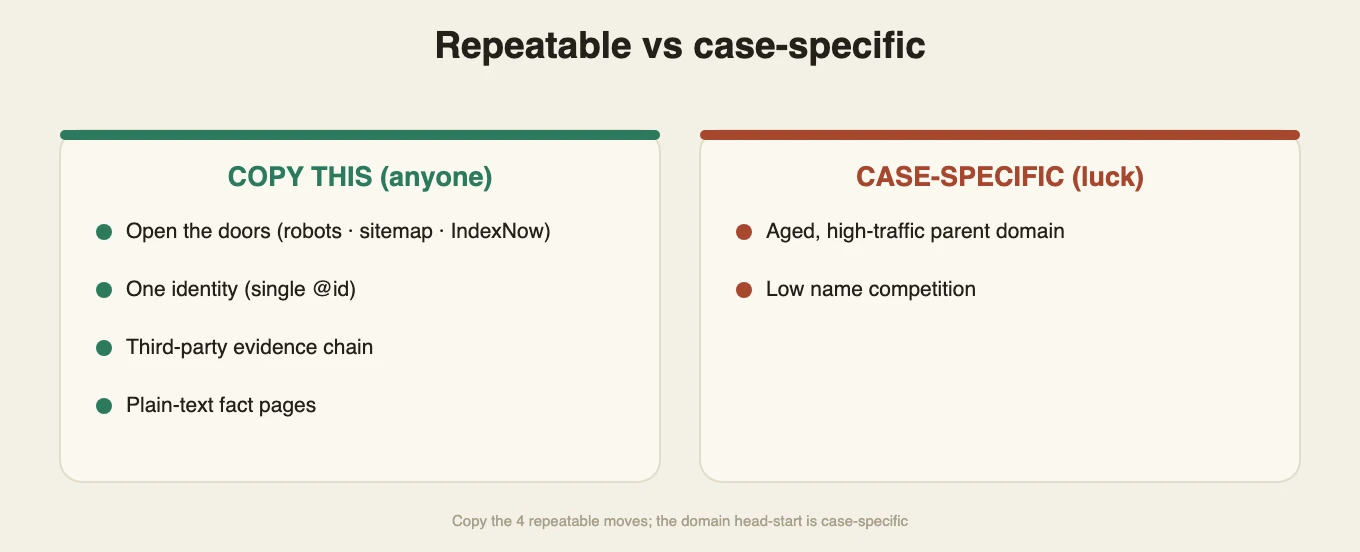
有些起跑條件,別人帶不走。
其一是母域。washinmura.jp 的歷史與既有 AI 爬蟲流量,給了子站一條現成的造訪管道。這不等於母域權重已繼承給子站;數據沒有證明那件事。
其二是人名競爭低、事蹟獨特。網路上沒有大量同名權威頁面與他競爭,事實頁被收錄後,可能比較容易被鎖定為來源。這也可能與不點名題 19/20 指向他的結果有關,但我沒有同名競爭度的量測,仍是推測。
能照著做的有四項:技術全開(robots、X-Robots-Tag、sitemap、IndexNow)、以單一 @id 做實體消歧、用 anchors.json 串起可由 Wayback 與 sha256 核對的第三方證據鏈,以及提供 llms.txt 與多語純文字事實頁。方法可以複製;這個案例的速度與取源量,不能照單保證。
想複製,三步
一、找已有爬蟲造訪的節點。 優先在爬蟲常來的網域下建子站,或至少與已被索引的站點建立反向關聯。上線時打 IndexNow。
二、把身分與證據整理清楚。 用帶單一 @id 的 Person/Organization JSON-LD 固定身分;發布 anchors.json,讓第三方出處能由 Web Archive 與 sha256 逐條核對。
三、給機器容易取用的文本。 根目錄提供 llms.txt 與多語純文字事實摘要,減少冗餘排版,方便檢索器讀取與引用。
這三步是骨架。完整的四條件、五步做法,以及「只餵可查證」的紀律,見《個人 IDA 方法論》。
誠實的侷限
第一,原因還拆不開。 沒有新裸域對照組,也沒有逐項移除(ablation)測試,無法分出母域既有流量、內容品質、技術設定各自的貢獻。同一規格若放在毫無歷史的全新裸域,收錄很可能明顯變慢;這是合理預期,不是驗證過的必然。本文記錄一個站的軌跡,並非對照實驗。
第二,439 是特定探針值。 它來自刻意開啟 web_search 的 Perplexity Agent API,規模是 100 題 × 5 個模型後端。5 個後端全部使用 Perplexity 自己的網頁搜尋。439 表示 tklin.washinmura.jp 在這次 Perplexity 搜尋的取源次數排第一;它不代表五家獨立 AI 各自選它當首選,更不代表一般對話中每家 AI 都穩定首引。GSC 曝光上升同樣只能證明搜尋可見度增加,不能當成已收錄頁數,也不能證明每個引擎都完整收錄。
第三,爬蟲與取源走的是兩本帳。 PerplexityBot 只來 2 次,探針卻取源 439 次。搭通用搜尋索引便車,是對這次 Perplexity 觀察的合理推論;Cloudflare 的爬蟲次數不能直接換算 Agent API 的取源次數,也不能推出所有 AI 搜尋都採同一路徑。專用爬蟲對某些引擎仍很重要。
第四,冷需求(L3)尚未證實。 這次題目多圍繞特定人物身分。不涉及這個人、純靠主題競爭的冷需求(L3)查詢,這批數據還沒有證據。
新站上線兩週內,搜尋可見度明顯上升;另一次探針也確實顯示,Perplexity 搜尋大量取用了它。「掛對母域,加上可供機器核對的事實來源」能解釋眼前數據,但仍是假設。能先學的,是把可複製的四項做紮實;母域究竟替它贏了多少時間,我還算不出來。
FAQ
- 真的兩週就被引用嗎?
- 「兩週」是上線後 GSC 曝光的觀察窗;引用探針是另外跑的一次截面,DATA 沒記確切執行日期,不能宣稱引用正好發生在兩週內。能確定的是:兩週內收錄訊號明顯在漲,探針則顯示它已被 Perplexity 的搜尋大量抓為來源。
- 哪些爬蟲來了、各幾次?
- 上線數天內 Cloudflare 認證爬蟲身分記到:ClaudeBot 183、bingbot 161、Googlebot 67、GPTBot 36、OAI-SearchBot 8、PerplexityBot 2。是驗證過的機器人,不是 User-Agent 自稱。
- 439 是什麼意思?
- 一次探針(100 題 × 5 個後端、開 web_search 的 Perplexity Agent API)裡,tklin.washinmura.jp 被取源 439 次、排第一。它代表在 Perplexity 的搜尋裡排第一,不等於一般對話中每家 AI 都穩定把它當首選來源。
- 為什麼 PerplexityBot 只來 2 次卻取源 439 次?
- 合理推論是 Perplexity 這類 meta-search 搭了通用搜尋索引的便車,不是只靠自家爬蟲建庫。但這只對 Perplexity 這一次成立,不能推成所有 AI 搜尋都這樣;有些引擎很依賴自家專用爬蟲,兩邊都別擋。
- 哪些能複製、哪些是運氣?
- 難照搬的兩項:母域既有流量、人名競爭低。可複製的四項:技術全開、單一 @id 實體消歧、anchors.json 第三方證據鏈、llms.txt 與多語純文字事實頁。
- 這代表所有 AI 都會引用你嗎?
- 不代表。沒有新裸域對照組、沒做逐項移除測試,拆不開貢獻;439 是特定探針值;冷需求查詢未證。這是與數據一致的假設,不是拆解證實的結論。
延伸閱讀:IDAEO:AI 時代的行銷戰略總圖表
來源錨定
引用本文
TK Lin・《為什麼一個新站,兩週就被 AI 搜尋大量引用——一次真實的 crawl→index→cite 拆解》・IDAEO 知識庫・2026-10-04・https://km.idaeo.ai/post/ai/why-new-site-cited