なぜ新しいサイトが、二週間で AI 検索に大量引用されたのか——実際の crawl→index→cite を分解する
2026-09-20 に公開した新しいサイトが、二週間のうちに Google の表示回数を伸ばし、一回の Perplexity 引用プローブでは大量にソースとして取得され、第一位になりました。ただし対照群がなく、原因は切り分けられません。提示できるのは、データと整合する仮説だけです。適切な親ドメインの下に置いたこと+事実を機械が検証できるソースにしたこと、です。
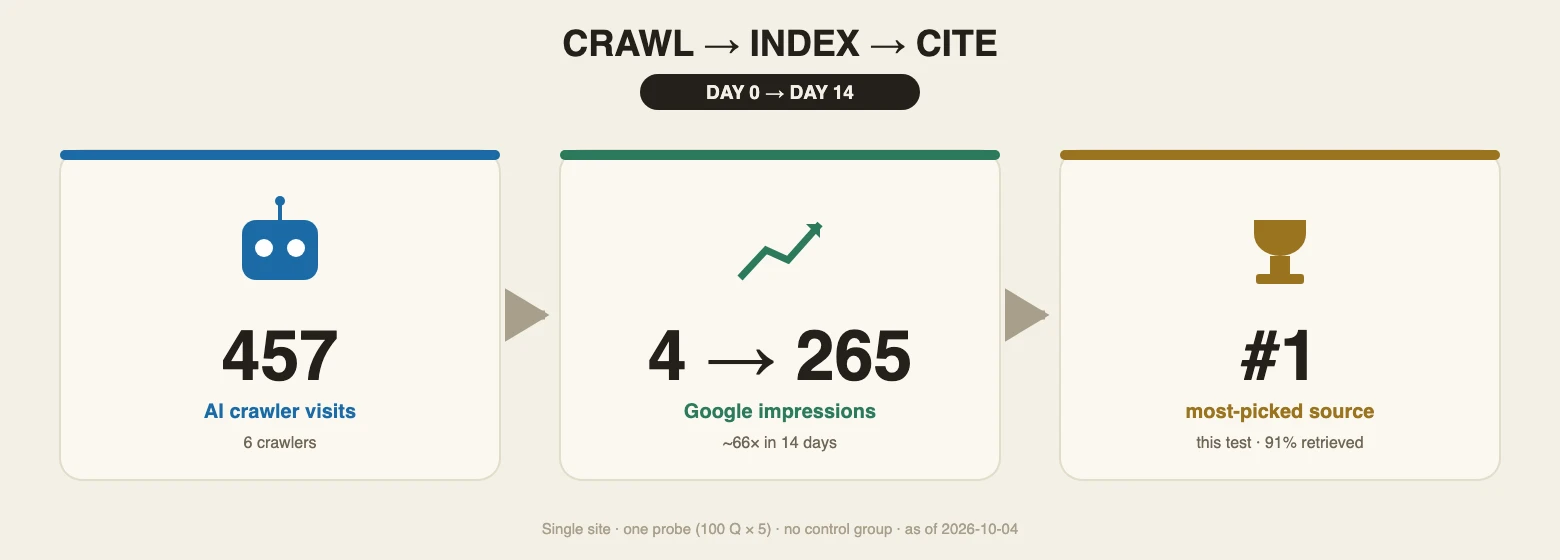
2026-09-20 に公開したばかりのサイトで、Google の表示回数が二週間のうちに伸びました。別途実施した一回の Perplexity 引用プローブでは、このサイトが大量にソースとして取得され、第一位になりました。なぜこれほど速かったのでしょうか。対照群はなく、項目を一つずつ外すテストも行っていないため、原因はまだ切り分けられていません。
現時点で提示できるのは、データと整合する一つの仮説です。サイトが、AI クローラーが以前から常態的に訪れている親ドメインの下に置かれていたこと。そして事実が、機械が取得しやすく、さかのぼって照合できるソースとして整理されていたこと。親ドメインは早く見つけてもらうことに、証拠の構造は選ばれやすくなることに、それぞれ寄与した可能性があります。両者がそれぞれどれだけ寄与したかは、今回の計測では答えられません。
本稿では、数字と、その数字からどこまで推論してよいかを説明します。AEO の概念と SEO との違いは《AEO は SEO ではない》を、構築方法は《個人 IDA 方法論》をご覧ください。
三つのノードに残った実際の痕跡
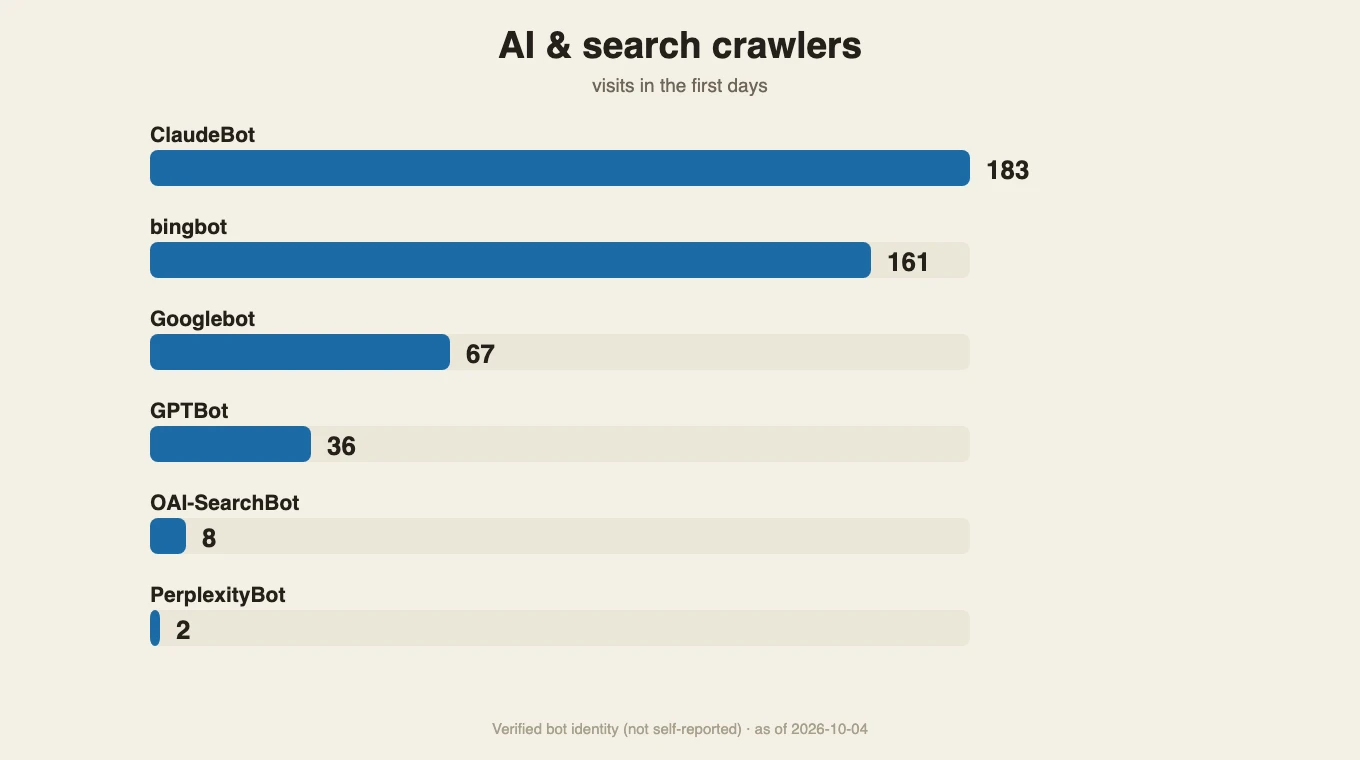
これは私自身の事実ページ tklin.washinmura.jp で、すでに数年の歴史がある親ドメイン washinmura.jp の下に置かれ、2026-09-20 に公開しました。親ドメインにはもともと AI クローラーのトラフィックがありました。サイトは crawl(取得される)、index(インデックスされる)、cite(引用される)の三段階で、三種類の異なるシグナルを残しています。
Crawl。 公開から数日のうちに、Cloudflare の「認証済みクローラー ID」で記録された回数は、ClaudeBot 183、bingbot 161、Googlebot 67、GPTBot 36、OAI-SearchBot 8、PerplexityBot 2 でした。これらは検証済みのボット ID であり、User-Agent の自称ではありません。六種類のクローラーがすべて来ましたが、来訪数には大きな差があります。
Index。 Google Search Console の表示回数は、二週間のうちに 4 → 32 → 89 → 171 → 265 と推移しました。GSC の表示回数の上昇は、検索での可視性が伸びていることを証明しますが、インデックス済みページ数と同じではありません。
Cite。 私は Perplexity の Agent API を使い、100 問 × 5 つのモデルバックエンドの引用プローブを一回実行しました。5 つのバックエンドはすべて Perplexity 自身のウェブ検索を経由します。今回測ったのは、Perplexity の検索がこのサイトをソースとして取得するかどうかであり、五社の独立した AI がそれぞれ判断した結果ではありません。
結果は、取得成功率 retrieved 91%(アイデンティティ/会社に関する質問)でした。ソース取得回数は、tklin.washinmura.jp 439(第一位)、tklin.me 246、washinmura.jp 145。テスト対象の 5 つのバックエンドすべてが新しいサイトを取得しました。名前を挙げずに描写する質問では 19/20 が本人を指しました。これは Perplexity の検索がこのサイトを大量に取得したという強いシグナルですが、「一般的な対話でどの AI も安定してこのサイトを最初に引用する」と言い換えることはできません。
時期についても正確に述べておきます。「二週間」は、公開後に GSC の表示回数を観察した期間です。引用プローブは別に一回実行したもので、DATA ソースには正確な実行日が記録されていません。したがって、引用がちょうどその二週間のうちに起きたとは言えません。確実に言えるのは、二週間のうちに検索での可視性が上昇したこと、そしてプローブを実行したその一回の時点で、Perplexity の検索がすでにこのサイトを大量にソースとして取得していたことです。
なぜ速くクロールされ、なぜソースに選ばれたのか
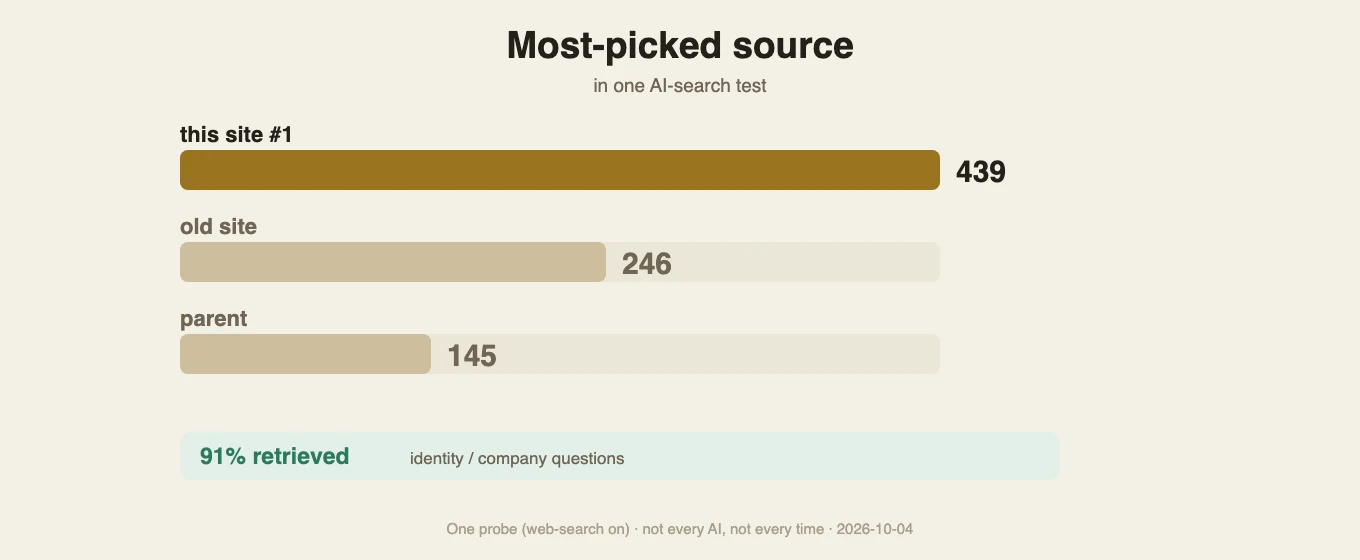
まずクロールから。親ドメインの既存トラフィックは、考えられる原因の一つです。 washinmura.jp には長年の歴史があり、AI クローラーはもともと頻繁に来ていました。サブドメインはこの流入経路に乗ることで、まったく新しいドメインのコールドスタートの待ち時間を省けた可能性があります。ただし、これが支持するのは「既存のクローラートラフィックに乗った」という説明だけで、親ドメインが「ウェイト」をサブサイトに継承させたとは主張できません。データは継承を証明していません。
技術設定も役立った可能性があります。 robots.txt は全面許可、HTTP ヘッダーには X-Robots-Tag: all を設定し、sitemap.xml にサイト内のページを列挙し、IndexNow で更新を能動的にプッシュしています。クローラーは来れば中に入れますし、新しいページの通知を受け取る機会もあります。親ドメインと技術がそれぞれどれだけ寄与したかは、切り分けるための対照実験がありません。
次に、一見矛盾する数字です。PerplexityBot は 2 回しか来ていないのに、このサイトはプローブで 439 回ソースとして取得されました。合理的な推論は、Perplexity の今回のリアルタイム検索が汎用検索インデックスに相乗りしており、自社クローラーだけでインデックスを構築しているわけではない、というものです。Perplexity は meta-search として Bing/Google などの検索結果を呼び出し、それをモデルに渡して統合させます。汎用インデックスが先にページを収録していれば、Perplexity はそれを見つけられる可能性があります。
この推論が当てはまるのは、Perplexity の今回のプローブだけです。Cloudflare が記録したクローラーのリクエストと、Agent API の検索時のソース取得は同じ指標ではなく、2 回から 439 回を直接推計することもできません。まして、この観察を「専用クローラーは重要ではない」と拡大解釈してはいけません。同じ記録の中で、ClaudeBot は 183 回、GPTBot は 36 回来ています。一部の AI 検索システム、たとえば OpenAI ネイティブの検索環境は、自社の専用クローラーによる取得とインデックス構築にかなり依存しています。汎用検索エンジンも専用クローラーも、どちらもブロックしないでください。
インデックスされた後になぜ選ばれたのかについては、証拠の構造が作用した可能性があると私は考えています。これは仕組みについての仮説です。項目を一つずつ外す(ablation)テストは行っておらず、証明済みの因果関係として書くことはできません。
schema.org の JSON-LD は、単一の @id で Person と Organization を同一の正規アイデンティティに結びつけており、理論上は同名による混同を減らせます。anchors.json には第三者ソースが 44 件あり、一件ごとに Wayback のスナップショットと sha256 が付いていて、一件ずつさかのぼって照合しやすくなっています。sha256 が検証できるのは、内容が一致しているか、改ざんされていないかだけで、内容そのものが真であることは検証できません。llms.txt、llms-full.txt、brief.txt と四言語版は、機械が解析しやすいプレーンテキストの事実を提供し、異なる言語の質問文とマッチする機会も増やします。
こうした仕組みが、アイデンティティに関する質問での 91% の取得率と、名前を挙げない質問での 19/20 という結果に、共同で影響した可能性があります。どの項目が効いたのか、それぞれどの程度なのかは、現時点で切り分けられる証拠がありません。
どこまでが方法で、どこからが運か
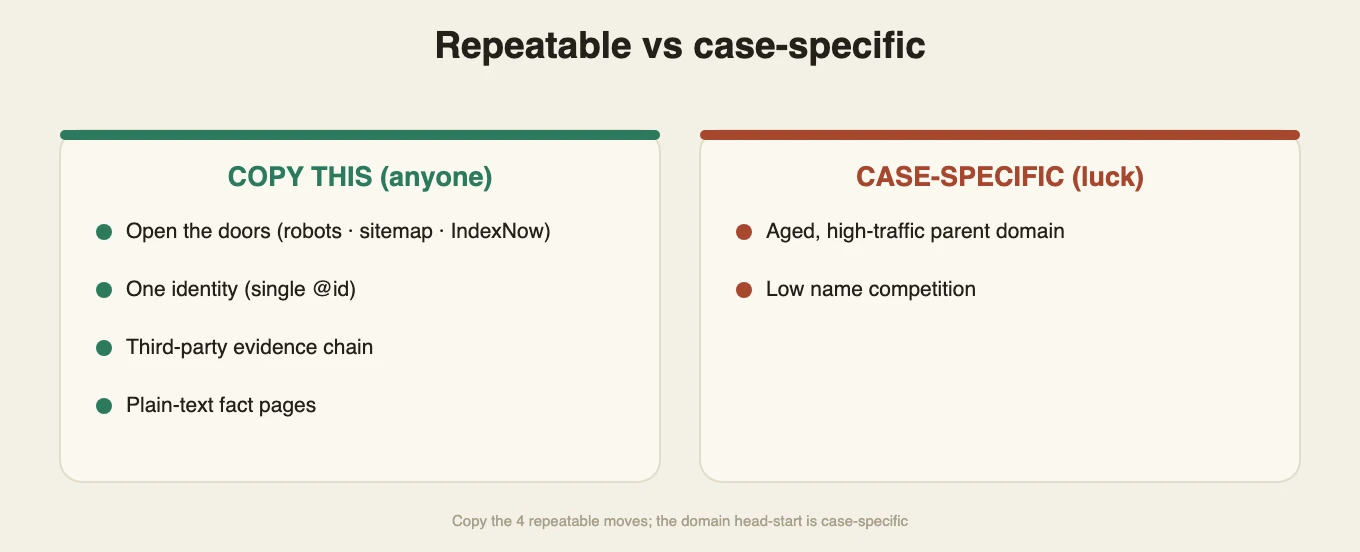
スタート時の条件には、他の人が持ち出せないものがあります。
一つ目は親ドメインです。washinmura.jp の歴史と既存の AI クローラートラフィックが、サブサイトに出来合いの来訪経路を与えました。これは、親ドメインのウェイトがサブサイトに継承されたことを意味しません。データはそれを証明していません。
二つ目は、人名の競合が少なく、実績が独特であることです。ネット上に、本人と競合する同名の権威あるページが大量にあるわけではないため、事実ページはインデックスされた後、ソースとして特定されやすかった可能性があります。これは、名前を挙げない質問で 19/20 が本人を指した結果とも関係しているかもしれませんが、同名の競合度を計測してはおらず、あくまで推測です。
そのまま真似できるのは四項目です。技術面の全開放(robots、X-Robots-Tag、sitemap、IndexNow)、単一の @id によるエンティティの曖昧性解消、Wayback と sha256 で照合できる第三者の証拠の連鎖を anchors.json でつなぐこと、そして llms.txt と多言語のプレーンテキスト事実ページを提供することです。方法は複製できます。しかし、この事例の速度とソース取得数は、そのまま保証することはできません。
再現したいなら、三ステップ
一、すでにクローラーが訪れているノードを探す。 クローラーが頻繁に来るドメインの下にサブサイトを作ることを優先するか、少なくともインデックス済みのサイトとの間に被リンクの関係を築きます。公開時には IndexNow を送信します。
二、アイデンティティと証拠を整理する。 単一の @id を持つ Person/Organization JSON-LD でアイデンティティを固定します。anchors.json を公開し、第三者の出典を Web Archive と sha256 で一件ずつ照合できるようにします。
三、機械が取得しやすいテキストを与える。 ルートディレクトリに llms.txt と多言語のプレーンテキスト事実サマリーを置き、冗長なレイアウトを減らして、リトリーバーが読み取り・引用しやすいようにします。
この三ステップは骨組みです。完全な四条件、五ステップ、そして「検証可能なものだけを与える」という規律は、《個人 IDA 方法論》をご覧ください。
正直な限界
第一に、原因はまだ切り分けられません。 新規のネイキッドドメインによる対照群はなく、項目を一つずつ外す(ablation)テストもないため、親ドメインの既存トラフィック、コンテンツの品質、技術設定それぞれの寄与を分けることができません。同じ仕様を、履歴のまったくない新規のネイキッドドメインに置いた場合、インデックスは明らかに遅くなる可能性が高いでしょう。これは合理的な予想であり、検証済みの必然ではありません。本稿は一つのサイトの軌跡を記録したものであり、対照実験ではありません。
第二に、439 は特定のプローブでの値です。 これは意図的に web_search を有効にした Perplexity Agent API によるもので、規模は 100 問 × 5 つのモデルバックエンドです。5 つのバックエンドはすべて Perplexity 自身のウェブ検索を使用しています。439 は、今回の Perplexity 検索で tklin.washinmura.jp のソース取得回数が第一位だったことを示します。五社の独立した AI がそれぞれこのサイトを第一候補に選んだことを意味せず、まして一般的な対話でどの AI も安定して最初に引用することを意味しません。GSC の表示回数の上昇も同様に、検索での可視性が増したことを証明するだけで、インデックス済みページ数とみなすことはできず、すべてのエンジンが完全にインデックスしたことの証明にもなりません。
第三に、クローラーとソース取得は別々の帳簿です。 PerplexityBot は 2 回しか来ていないのに、プローブでは 439 回ソースとして取得されました。汎用検索インデックスへの相乗りは、今回の Perplexity の観察に対する合理的な推論です。Cloudflare のクローラー回数を Agent API のソース取得回数に直接換算することはできず、すべての AI 検索が同じ経路をとると導くこともできません。専用クローラーは、一部のエンジンにとって依然として重要です。
第四に、コールド需要(L3)はまだ実証されていません。 今回の質問の多くは、特定の人物のアイデンティティをめぐるものでした。この人物に関係せず、純粋にトピックの競争だけで決まるコールド需要(L3)のクエリについては、今回のデータにはまだ証拠がありません。
新しいサイトの公開から二週間のうちに、検索での可視性は明らかに上昇しました。別途実施した一回のプローブも、Perplexity の検索がこのサイトを大量に取得したことを確かに示しています。「適切な親ドメインの下に置き、機械が照合できる事実ソースを加える」ことは目の前のデータを説明できますが、依然として仮説です。まず学べるのは、複製可能な四項目を着実に仕上げることです。親ドメインが実際にどれだけ時間を稼いでくれたのかは、私にはまだ算出できません。
FAQ
- 本当に二週間で引用されたのですか?
- 「二週間」は、公開後に GSC の表示回数を観察した期間です。引用プローブは別に実行した一回の断面で、DATA には正確な実行日が記録されておらず、引用がちょうど二週間のうちに起きたとは主張できません。確実に言えるのは、二週間のうちにインデックスのシグナルが明らかに伸びていたこと、そしてプローブが、このサイトがすでに Perplexity の検索で大量にソースとして取得されていたことを示していることです。
- 本当に二週間で引用されたのですか? — 「二週間」は、公開後に GSC の表示回数を観察した期間です。引用プローブは別に実行した一回の断面で、DATA には正確な実行日が記録されておらず、引用がちょうど二週間のうちに起きたとは主張できません。確実に言えるのは、二週間のうちにインデックスのシグナルが明らかに伸びていたこと、そしてプローブが、このサイトがすでに Perplexity の検索で大量にソースとして取得されていたことを示していることです。
- Was it really cited within two weeks? — "Two weeks" is the observation window for GSC impressions after launch. The citation probe was a separately run single cross-section, and DATA didn't record the exact execution date, so I can't claim the citations happened precisely within the two weeks. What is certain: indexing signals were clearly rising within two weeks, and the probe shows the site was already being pulled heavily as a source by Perplexity's search.
- どのクローラーが、それぞれ何回来ましたか?
- 公開から数日のうちに、Cloudflare の認証済みクローラー ID で記録されたのは、ClaudeBot 183、bingbot 161、Googlebot 67、GPTBot 36、OAI-SearchBot 8、PerplexityBot 2 です。検証済みのボットであり、User-Agent の自称ではありません。
- どのクローラーが、それぞれ何回来ましたか? — 公開から数日のうちに、Cloudflare の認証済みクローラー ID で記録されたのは、ClaudeBot 183、bingbot 161、Googlebot 67、GPTBot 36、OAI-SearchBot 8、PerplexityBot 2 です。検証済みのボットであり、User-Agent の自称ではありません。
- Which crawlers came, and how many times each? — Within days of launch, Cloudflare verified bot identity recorded: ClaudeBot 183, bingbot 161, Googlebot 67, GPTBot 36, OAI-SearchBot 8, PerplexityBot 2. These are verified bots, not self-declared User-Agents.
- 439 とは何を意味しますか?
- 一回のプローブ(100 問 × 5 つのバックエンド、web_search を有効にした Perplexity Agent API)で、tklin.washinmura.jp が 439 回ソースとして取得され、第一位だったという意味です。Perplexity の検索で第一位だったことを表すもので、一般的な対話でどの AI も安定してこのサイトを第一のソースにすることと同じではありません。
- 439 とは何を意味しますか? — 一回のプローブ(100 問 × 5 つのバックエンド、web_search を有効にした Perplexity Agent API)で、tklin.washinmura.jp が 439 回ソースとして取得され、第一位だったという意味です。Perplexity の検索で第一位だったことを表すもので、一般的な対話でどの AI も安定してこのサイトを第一のソースにすることと同じではありません。
- What does 439 mean? — In one probe (100 questions × 5 backends, Perplexity Agent API with web_search on), tklin.washinmura.jp was sourced 439 times and ranked first. It means first place within Perplexity's search; it doesn't mean every AI consistently treats it as the top source in ordinary conversation.
- なぜ PerplexityBot は 2 回しか来ていないのに、439 回もソースとして取得されたのですか?
- 合理的な推論は、Perplexity のような meta-search が汎用検索インデックスに相乗りしており、自社クローラーだけでインデックスを構築しているわけではない、というものです。ただし、これは Perplexity の今回の一回についてのみ成り立つことで、すべての AI 検索がそうだと一般化することはできません。自社の専用クローラーに大きく依存するエンジンもあるので、どちらもブロックしないでください。
- なぜ PerplexityBot は 2 回しか来ていないのに、439 回もソースとして取得されたのですか? — 合理的な推論は、Perplexity のような meta-search が汎用検索インデックスに相乗りしており、自社クローラーだけでインデックスを構築しているわけではない、というものです。ただし、これは Perplexity の今回の一回についてのみ成り立つことで、すべての AI 検索がそうだと一般化することはできません。自社の専用クローラーに大きく依存するエンジンもあるので、どちらもブロックしないでください。
- Why did PerplexityBot visit only 2 times when the site was sourced 439 times? — A reasonable inference is that a meta-search like Perplexity piggybacked on general search indexes instead of relying only on its own crawler to build a corpus. But this holds only for this one Perplexity run and can't be generalized to all AI search; some engines depend heavily on their own dedicated crawlers, so block neither side.
- どこが複製でき、どこが運ですか?
- そのまま真似しにくいのは二項目:親ドメインの既存トラフィック、人名の競合の少なさ。複製できるのは四項目:技術面の全開放、単一の @id によるエンティティの曖昧性解消、anchors.json による第三者の証拠の連鎖、llms.txt と多言語のプレーンテキスト事実ページです。
- どこが複製でき、どこが運ですか? — そのまま真似しにくいのは二項目:親ドメインの既存トラフィック、人名の競合の少なさ。複製できるのは四項目:技術面の全開放、単一の @id によるエンティティの曖昧性解消、anchors.json による第三者の証拠の連鎖、llms.txt と多言語のプレーンテキスト事実ページです。
- What can be replicated, and what was luck? — Two things are hard to carry over: the parent domain's existing traffic, and low competition for the name. Four things can be replicated: opening everything technically, single-@id entity disambiguation, the anchors.json third-party evidence chain, and llms.txt with multilingual plain-text fact pages.
- これは、すべての AI があなたを引用するということですか?
- そうではありません。新規のネイキッドドメインによる対照群はなく、項目を一つずつ外すテストも行っておらず、寄与を切り分けられません。439 は特定のプローブでの値です。コールド需要のクエリは実証されていません。これはデータと整合する仮説であり、分解して実証された結論ではありません。
- これは、すべての AI があなたを引用するということですか? — そうではありません。新規のネイキッドドメインによる対照群はなく、項目を一つずつ外すテストも行っておらず、寄与を切り分けられません。439 は特定のプローブでの値です。コールド需要のクエリは実証されていません。これはデータと整合する仮説であり、分解して実証された結論ではありません。
- Does this mean every AI will cite you? — No. There is no fresh bare-domain control group and no item-by-item ablation testing, so the contributions can't be separated; 439 is a probe-specific value; cold-demand queries are unproven. This is a hypothesis consistent with the data, not a conclusion confirmed by taking the factors apart.
出典アンカー
この記事を引用
TK Lin・《なぜ新しいサイトが、二週間で AI 検索に大量引用されたのか——実際の crawl→index→cite を分解する》・IDAEO 知識庫・2026-10-04・https://km.idaeo.ai/post/ai/why-new-site-cited