AEO 不是 SEO:答案引擎最佳化的定義、原理與做法
AEO 是讓 AI 回答時引用你「可查證的官方版本」的工作,本質是身分與事實來源治理,不是關鍵字排名。SEO 看排名與點擊,AEO 看 AI 有沒有用你、用得對不對。
有人點進你的網站,和 AI 拿你的內容回答,是兩種成績。這篇談 AEO 的定義、它和 SEO 的差別,以及我怎麼理解背後的原理。實測數字與機制拆解,見《為什麼一個新站,兩週就被 AI 搜尋大量引用》;建置方法,見《個人 IDA 方法論》。
定義
AEO(Answer Engine Optimization,答案引擎優化)是讓 AI 回答問題時,引用你「可查證的官方版本」作為來源的工作;核心是身分與事實來源治理,不是關鍵字排名。
重點有三個。目標是 AI 的回答;來源應是你願意負責的官方版本;你要處理的是「誰是誰、哪些事實查得到」,而非詞頻。
所以,AEO 要問的不是「我排第幾」,而是 AI 替我說話時,拿到的資料對不對、能不能查。
與 SEO 的差異
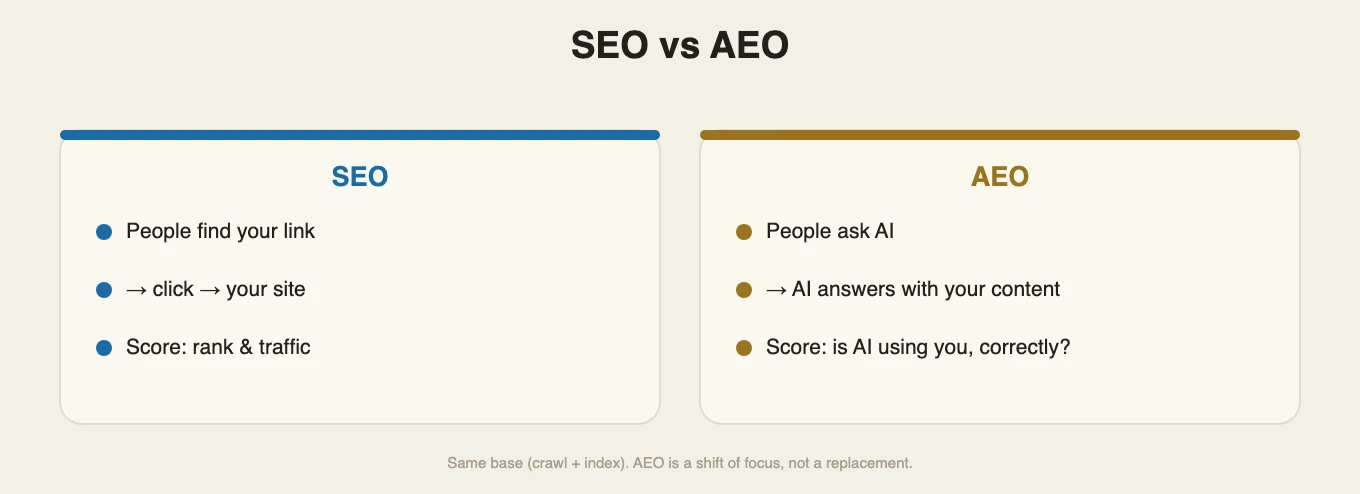
SEO 長年重視連結能否被找到、被點開,成果主要看排名與流量。AEO 追的是另一段路:使用者可能一次都沒點進來,AI 已在對話或 agent 流程中取用了你的內容。這時要量的是它有沒有用,以及用得對不對。
兩者都得先過「能被爬、能被收錄」這一關。AEO 接著問:AI 取用時,抓到的是不是你認可、而且查得證的版本。
想像一個頁面幾乎沒有點擊,卻進了 AI 的回答。用流量記分,它不起眼;用來源取用記分,它有作用。這只是說明兩套記分板的示意,不是我量到的逐日數據。我手上的引用探針只有一次截面,不能宣稱它「天天被引用」。
原理:crawl → index → cite
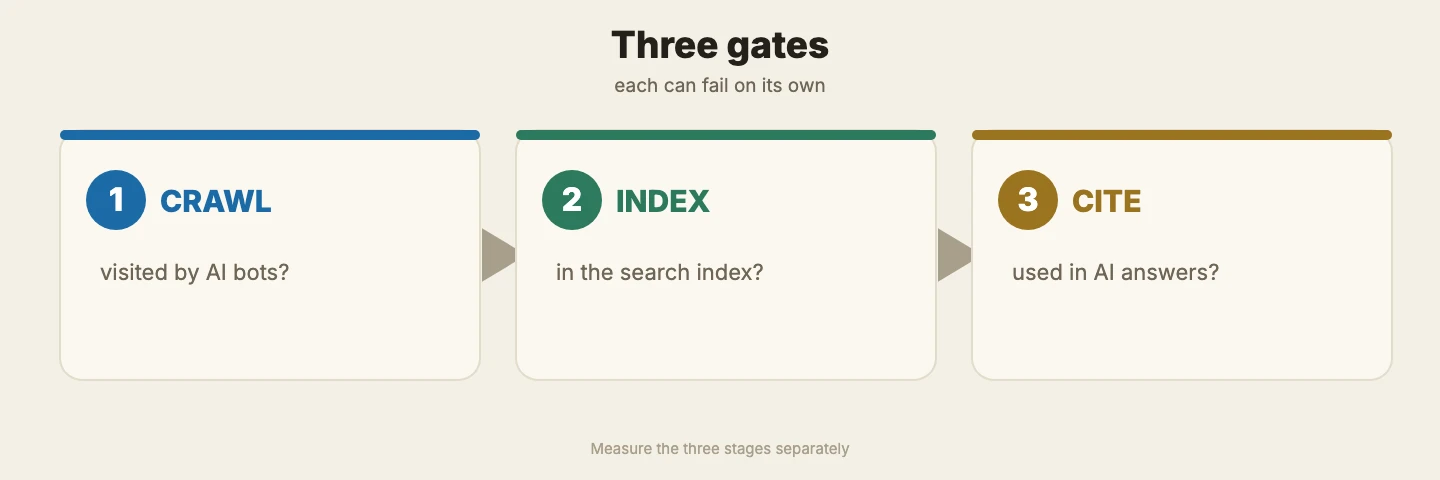
我把內容進入 AI 回答的路徑拆成三段:
- crawl(被爬):爬蟲有沒有抓到頁面。
- index(被收錄):搜尋索引有沒有收進去。
- cite(被引用):AI 回答有沒有拿它當來源。
三段都要量。被爬不保證被收錄;被收錄也不保證被引用。我的案例甚至出現一家爬蟲只來極少次,頁面卻在它的搜尋探針裡被大量取源。
對那次 Perplexity 探針,一個合理推論是:Perplexity 這類 meta-search 的即時檢索搭了通用搜尋索引的便車,並非只靠自家爬蟲建庫。這只解釋 Perplexity 的這一次觀察,不能推到所有 AI 搜尋。有些引擎很依賴自家專用爬蟲,通用搜尋與專用爬蟲都不該擋。數字與反例,見《為什麼一個新站,兩週就被 AI 搜尋大量引用》。
只看爬蟲日誌會錯估引用;只看收錄,也不知道最後有沒有被用。crawl、index、cite 各有自己的帳。
什麼讓一份內容「可被引用」
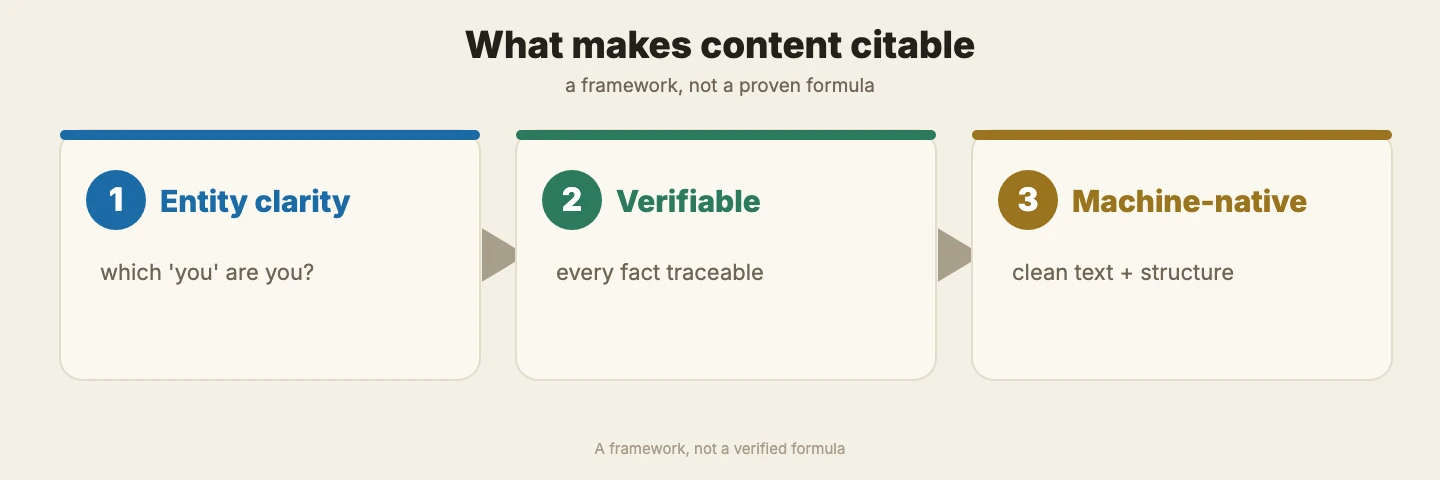
我用三根支柱整理這件事。它們是思考框架,不是已證明的充要公式。
- 實體消歧:先讓機器知道「你是哪一個你」。同名的人、新舊網站、不同語言版本若被混成一團,回答就容易漏掉你,或引錯人。跨站、跨語言指向同一個正規身分,能減少這種猜測。
- 可查證的證據鏈:事實要能逐條回到原始來源或公開紀錄,讓第三方自行核對、重算。只寫「我說我是」,撐不起需要引用的答案。
- AI 原生文本:提供結構化資料與乾淨的純文字版本,讓機器容易剖析、取用。給人看的排版與給機器讀的結構,可以各司其職。
在這個框架裡,我把「消歧 × 查證 × 機器可讀」視為可能共同影響取源的條件;少一項,可能就弱一分。但我沒有做逐項移除測試,不能證明各項效果,更不能把它寫成公式。機制假設見《為什麼一個新站,兩週就被 AI 搜尋大量引用》;單一 `@id` 的 schema.org、錨點清單、llms.txt 系列、爬蟲設定與三源量測怎麼做,見《個人 IDA 方法論》的四條件與五步做法。
誠實侷限
這套說法目前只得到一個案例支持,還不是經多案例驗證的定律。那個站掛在已有 AI 爬蟲流量管道的母域下;我沒有新裸域對照組,也沒有做逐項移除測試,拆不開母域、內容與技術設定各自的貢獻。它搭上了母域既有流量,但數據沒有證明母域把「權重」繼承給子站。
「被大量引用」來自開啟 web_search 的 Perplexity Agent API 探針。受測的 5 個後端走的都是 Perplexity 自己的網頁搜尋;量到的是 Perplexity 搜尋會不會抓它當來源,並非五家獨立 AI 各自判斷。這也不等於一般對話裡,各家 AI 都會穩定首引它。
冷需求(L3,也就是不涉及這個人、純靠主題競爭的查詢)尚未證實。更完整的量測條件與保留,見《為什麼一個新站,兩週就被 AI 搜尋大量引用》的誠實侷限段。框架能解釋眼前的數據,還不能保證照做就有相同結果。
一句話總結
SEO 讓人找到你的連結;AEO 要讓 AI 用你能負責的版本回答。要知道自己做到了哪一步,就把 crawl、index、cite 分開量。
FAQ
- AEO 和 SEO 一樣嗎?
- 不一樣,但不互斥。SEO 看排名與流量,AEO 看 AI 取用你的內容為答案、用得對不對。兩者共用同一套地基:能被爬、能被收錄;AEO 在這之上多問一件事——AI 抓到的是不是你認可、而且查得證的版本。
- AEO 的中文是什麼?
- 答案引擎最佳化(Answer Engine Optimization)。優化的對象是 AI 回答時手上的資料是不是你認可、查得證的版本,不是搜尋排名。
- 幾乎沒有點擊的頁面有意義嗎?
- 可能有。一個頁面可以幾乎沒有點擊,卻在 AI 回答時被當成來源。在 SEO 記分板上它不起眼,在 AEO 記分板上它有作用。這是說明兩套記分板不同的示意,不是逐日數據。
- crawl、index、cite 是什麼?
- 內容進入 AI 回答的三段:被爬、被收錄、被引用。它們不會自動相連,每一段都可能獨立失敗;要各自量、各自報,不能合併成一個總分。
- 什麼讓一份內容「可被引用」?
- 概念上靠三件治理工作:實體消歧、可查證的證據鏈、AI 原生文本。這是思考框架,不是已證明的充要公式。
- 照這套做就一定有效嗎?
- 不保證。支持它的實測目前只有單一案例,且掛在已有 AI 爬蟲流量的母域下,拆不開母域、內容、技術的貢獻。框架講得通,不等於照做就有相同結果。
延伸閱讀:IDAEO:AI 時代的行銷戰略總圖表
來源錨定
引用本文
TK Lin・《AEO 不是 SEO:答案引擎最佳化的定義、原理與做法》・IDAEO 知識庫・2026-10-04・https://km.idaeo.ai/post/ai/aeo-vs-seo