AEO は SEO ではない:回答エンジン最適化の定義・原理・実践
AEO は、AI が回答する際に、あなたの「検証可能な公式版」を引用させるための取り組みです。本質はアイデンティティと事実ソースのガバナンスであり、キーワード順位ではありません。SEO は順位とクリックを見て、AEO は AI があなたを使ったか、正しく使ったかを見ます。
人があなたのサイトをクリックして訪れることと、AI があなたのコンテンツを使って回答することは、別々の成績です。本稿では、AEO の定義、SEO との違い、そして背後にある原理を私がどう理解しているかを述べます。実測値と仕組みの分解は《なぜ新しいサイトが、二週間で AI 検索に大量引用されたのか》を、構築方法は《個人 IDA 方法論》をご覧ください。
定義
AEO(Answer Engine Optimization、回答エンジン最適化)とは、AI が質問に答える際に、あなたの「検証可能な公式版」をソースとして引用させるための取り組みです。核心はアイデンティティと事実ソースのガバナンスであり、キーワード順位ではありません。
ポイントは三つあります。対象は AI の回答であること。ソースは、あなたが責任を持てる公式版であるべきこと。扱うべきは「誰が誰なのか、どの事実が確認できるのか」であって、語の出現頻度ではないこと。
したがって、AEO が問うのは「自分は何位か」ではありません。AI が自分の代わりに語るとき、手にしている情報が正しいか、検証できるかです。
SEO との違い
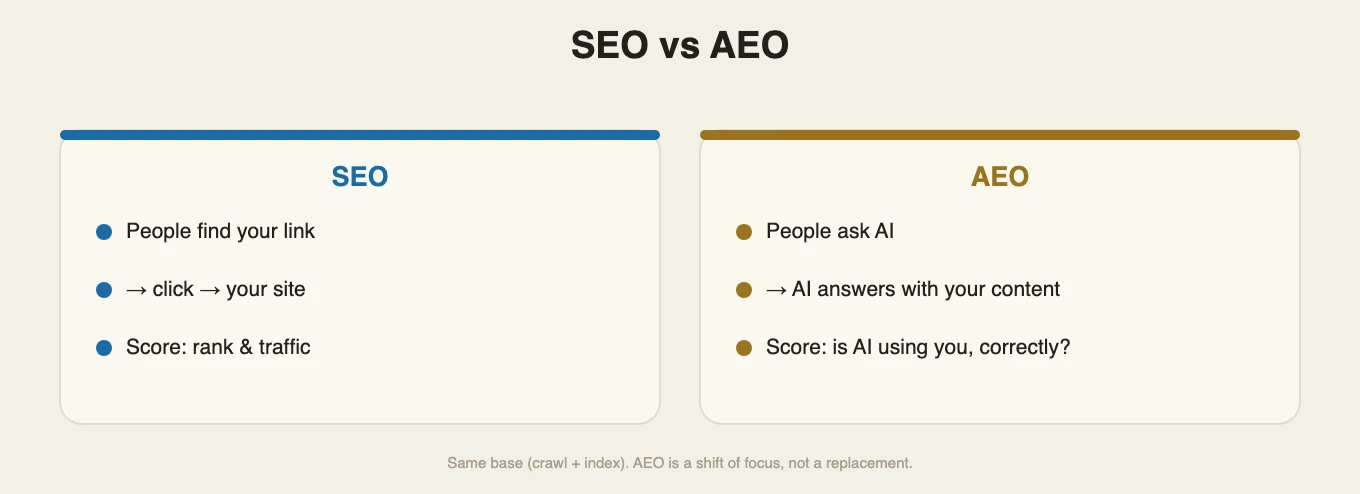
SEO は長年、リンクが見つけられ、クリックされるかを重視し、成果は主に順位とトラフィックで測ってきました。AEO が追うのは別の経路です。ユーザーが一度もクリックして訪れていなくても、AI は対話や agent のフローの中で、すでにあなたのコンテンツを取り込んでいるかもしれません。このとき測るべきは、使われたかどうか、そして正しく使われたかどうかです。
どちらもまず「クロールされ、インデックスされる」という関門を通らなければなりません。AEO はその先を問います。AI が取り込むとき、掴んだのはあなたが認め、しかも検証できる版なのか、と。
クリックがほとんどないのに、AI の回答には入っているページを想像してください。トラフィックで採点すれば目立ちませんが、ソースとしての取得で採点すれば役割を果たしています。これは二つのスコアボードの違いを説明するための例示にすぎず、私が計測した日次データではありません。手元の引用プローブは一回の断面しかなく、「毎日引用されている」とは主張できません。
原理:crawl → index → cite
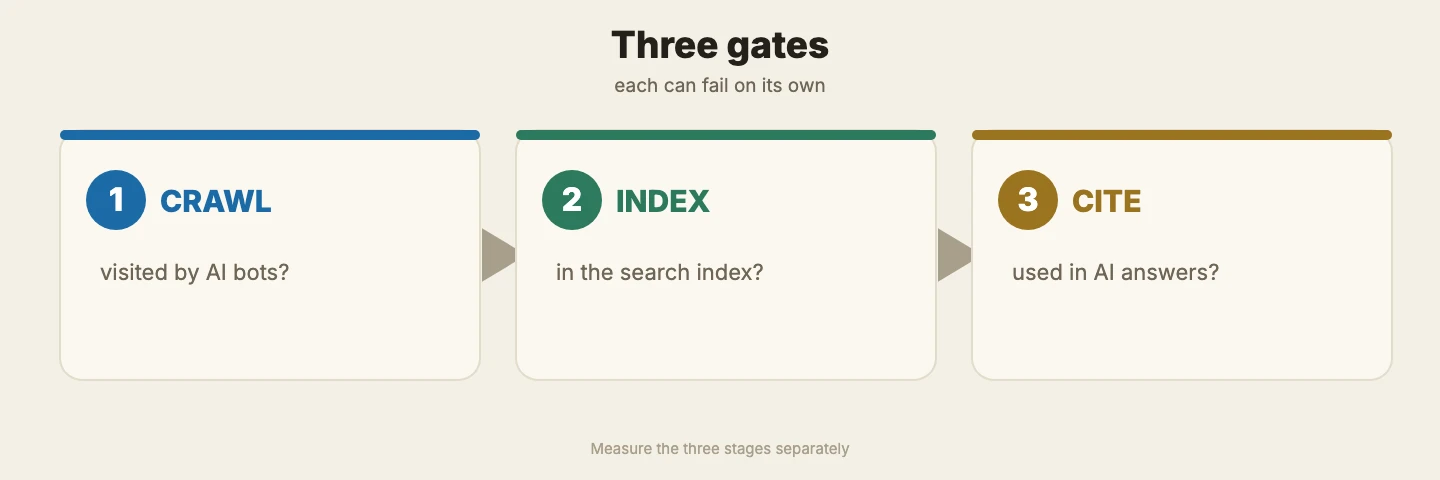
私は、コンテンツが AI の回答に入るまでの経路を三段階に分けています。
- crawl(クロールされる):クローラーがページを取得したか。
- index(インデックスされる):検索インデックスに収録されたか。
- cite(引用される):AI の回答がそれをソースとして使ったか。
三段階すべてを測る必要があります。クロールされてもインデックスされるとは限らず、インデックスされても引用されるとは限りません。私の事例では、あるクローラーがごくわずかしか来ていないのに、その検索プローブではページが大量にソースとして取得される、ということさえ起きました。
あの Perplexity プローブについて、合理的な推論の一つはこうです。Perplexity のような meta-search のリアルタイム検索は、汎用検索インデックスに相乗りしており、自社クローラーだけでインデックスを構築しているわけではない。これは Perplexity のこの一回の観察を説明するだけで、すべての AI 検索に当てはめることはできません。自社の専用クローラーに大きく依存するエンジンもあり、汎用検索も専用クローラーもブロックすべきではありません。数字と反例は《なぜ新しいサイトが、二週間で AI 検索に大量引用されたのか》をご覧ください。
クローラーのログだけを見ると引用を見誤ります。インデックスだけを見ても、最終的に使われたかどうかは分かりません。crawl、index、cite にはそれぞれ別の帳簿があります。
コンテンツを「引用可能」にするもの
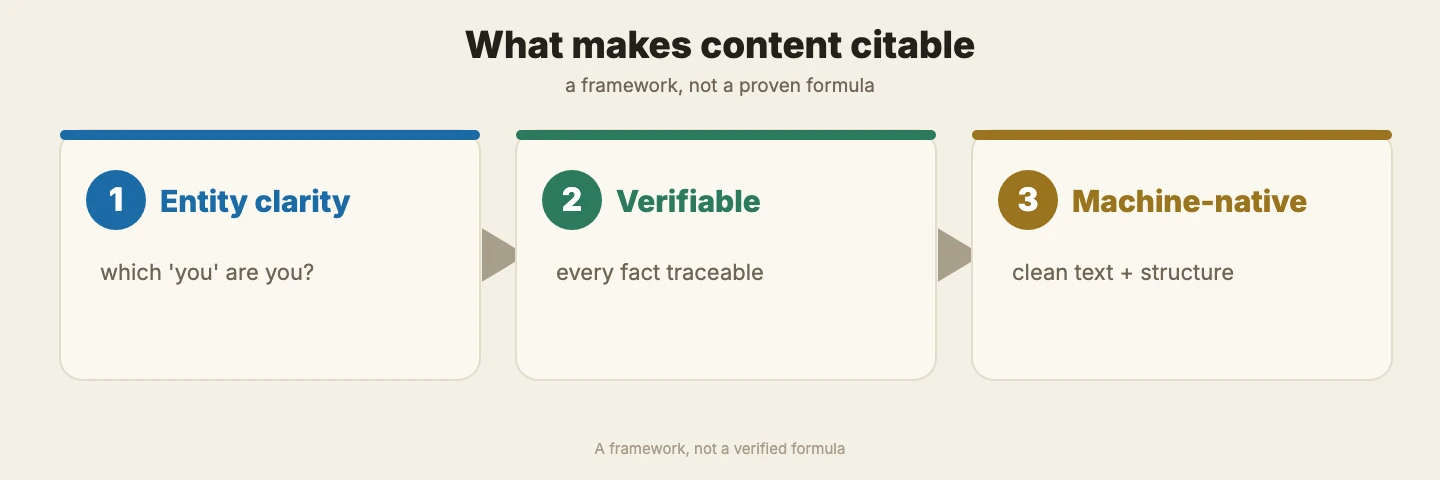
私はこれを三本の柱で整理しています。これらは思考のフレームワークであり、証明済みの必要十分な公式ではありません。
- エンティティの曖昧性解消:まず機械に「あなたがどのあなたなのか」を分からせます。同名の人物、新旧のサイト、異なる言語版が一緒くたにされると、回答からあなたが漏れたり、別人が引用されたりしやすくなります。サイトや言語をまたいで同一の正規アイデンティティを指し示せば、こうした推測を減らせます。
- 検証可能な証拠の連鎖:事実は一件ずつ原典や公開記録にさかのぼれ、第三者が自分で照合・再計算できなければなりません。「私がそうだと言っている」と書くだけでは、引用を必要とする回答を支えられません。
- AI ネイティブなテキスト:構造化データとクリーンなプレーンテキスト版を提供し、機械が解析・取得しやすくします。人に見せるレイアウトと機械に読ませる構造は、それぞれの役割を担えます。
このフレームワークでは、「曖昧性解消 × 検証 × 機械可読」を、ソース取得に共同で影響しうる条件と捉えています。一つ欠ければ、その分弱くなるかもしれません。ただし、項目を一つずつ外すテストは行っておらず、各項目の効果を証明することはできませんし、まして公式として書くことはできません。仕組みの仮説は《なぜ新しいサイトが、二週間で AI 検索に大量引用されたのか》を、単一 `@id` の schema.org、アンカー一覧、llms.txt 系、クローラー設定、三ソース計測の進め方は《個人 IDA 方法論》の四条件と五ステップをご覧ください。
正直な限界
この説明を支持しているのは現時点で一つの事例だけで、複数事例で検証された法則ではまだありません。そのサイトは、すでに AI クローラーの流入経路を持つ親ドメインの下に置かれています。新規のネイキッドドメインによる対照群はなく、項目を一つずつ外すテストも行っていないため、親ドメイン・コンテンツ・技術設定それぞれの寄与を切り分けられません。親ドメインの既存トラフィックには乗りましたが、親ドメインが「ウェイト」をサブサイトに継承させたことをデータは証明していません。
「大量に引用された」は、web_search を有効にした Perplexity Agent API プローブによるものです。テスト対象の 5 つのバックエンドはいずれも Perplexity 自身のウェブ検索を経由しています。測ったのは Perplexity の検索がこのサイトをソースとして取得するかどうかであり、五社の独立した AI がそれぞれ判断した結果ではありません。また、一般的な対話で各社の AI が安定してこのサイトを最初に引用することとも同じではありません。
コールド需要(L3、つまりこの人物に関係せず、純粋にトピックの競争だけで決まるクエリ)はまだ実証されていません。より詳しい計測条件と留保は、《なぜ新しいサイトが、二週間で AI 検索に大量引用されたのか》の「正直な限界」の節をご覧ください。このフレームワークは目の前のデータを説明できますが、同じようにやれば同じ結果が出ると保証することはまだできません。
一言でまとめると
SEO は人にあなたのリンクを見つけてもらうもの。AEO は AI に、あなたが責任を持てる版で回答させるものです。自分がどの段階まで到達したかを知るには、crawl、index、cite を分けて測ります。
FAQ
- AEO と SEO は同じですか?
- 同じではありませんが、互いに排他的でもありません。SEO は順位とトラフィックを見て、AEO は AI があなたのコンテンツを回答に取り込んだか、正しく使ったかを見ます。両者は同じ土台、つまりクロールされること・インデックスされることを共有しています。AEO はその上でもう一つ問います——AI が掴んだのは、あなたが認め、しかも検証できる版なのか、と。
- AEO と SEO は同じですか? — 同じではありませんが、互いに排他的でもありません。SEO は順位とトラフィックを見て、AEO は AI があなたのコンテンツを回答に取り込んだか、正しく使ったかを見ます。両者は同じ土台、つまりクロールされること・インデックスされることを共有しています。AEO はその上でもう一つ問います——AI が掴んだのは、あなたが認め、しかも検証できる版なのか、と。
- Are AEO and SEO the same thing? — No, but they aren't mutually exclusive. SEO looks at ranking and traffic; AEO looks at whether AI draws on your content for its answers and whether it does so correctly. They share one foundation, being crawlable and indexable, and AEO asks one more thing on top: is what the AI grabs the version you endorse and that can be verified?
- AEO は日本語で何と言いますか?
- 回答エンジン最適化(Answer Engine Optimization)です。最適化の対象は、AI が回答する際に手にしている情報が、あなたが認め、検証できる版であるかどうかであり、検索順位ではありません。
- AEO は日本語で何と言いますか? — 回答エンジン最適化(Answer Engine Optimization)です。最適化の対象は、AI が回答する際に手にしている情報が、あなたが認め、検証できる版であるかどうかであり、検索順位ではありません。
- What does AEO stand for? — Answer Engine Optimization. What gets optimized is whether the material the AI holds when it answers is the version you endorse and that can be verified, not search ranking.
- クリックがほとんどないページに意味はありますか?
- ありえます。ページはクリックがほとんどなくても、AI の回答時にソースとして使われることがあります。SEO のスコアボードでは目立ちませんが、AEO のスコアボードでは役割を果たしています。これは二つのスコアボードが異なることを説明するための例示であり、日次データではありません。
- クリックがほとんどないページに意味はありますか? — ありえます。ページはクリックがほとんどなくても、AI の回答時にソースとして使われることがあります。SEO のスコアボードでは目立ちませんが、AEO のスコアボードでは役割を果たしています。これは二つのスコアボードが異なることを説明するための例示であり、日次データではありません。
- Does a page with almost no clicks matter? — It may. A page can have almost no clicks and still be used as a source when AI answers. On the SEO scoreboard it is unremarkable; on the AEO scoreboard it is doing work. This is an illustration of how the two scoreboards differ, not day-by-day data.
- crawl、index、cite とは何ですか?
- コンテンツが AI の回答に入るまでの三段階、つまりクロールされる、インデックスされる、引用される、です。これらは自動的にはつながらず、どの段階も独立して失敗しえます。それぞれ測り、それぞれ報告すべきで、一つの総合スコアにまとめてはいけません。
- crawl、index、cite とは何ですか? — コンテンツが AI の回答に入るまでの三段階、つまりクロールされる、インデックスされる、引用される、です。これらは自動的にはつながらず、どの段階も独立して失敗しえます。それぞれ測り、それぞれ報告すべきで、一つの総合スコアにまとめてはいけません。
- What are crawl, index, and cite? — The three stages by which content enters an AI answer: being crawled, being indexed, being cited. They don't connect automatically, and each can fail on its own; measure and report each separately rather than merging them into one total score.
- コンテンツを「引用可能」にするものは何ですか?
- 概念的には、三つのガバナンス作業によります。エンティティの曖昧性解消、検証可能な証拠の連鎖、AI ネイティブなテキストです。これは思考のフレームワークであり、証明済みの必要十分な公式ではありません。
- コンテンツを「引用可能」にするものは何ですか? — 概念的には、三つのガバナンス作業によります。エンティティの曖昧性解消、検証可能な証拠の連鎖、AI ネイティブなテキストです。これは思考のフレームワークであり、証明済みの必要十分な公式ではありません。
- What makes content "citable"? — Conceptually, three pieces of governance work: entity disambiguation, a verifiable evidence chain, and AI-native text. This is a framework for thinking, not a proven necessary-and-sufficient formula.
- この通りにやれば必ず効果がありますか?
- 保証はできません。これを支持する実測は現時点で単一の事例だけで、しかもすでに AI クローラーのトラフィックがある親ドメインの下に置かれており、親ドメイン・コンテンツ・技術の寄与を切り分けられません。フレームワークとして筋が通っていることと、同じようにやれば同じ結果が出ることは別です。
- この通りにやれば必ず効果がありますか? — 保証はできません。これを支持する実測は現時点で単一の事例だけで、しかもすでに AI クローラーのトラフィックがある親ドメインの下に置かれており、親ドメイン・コンテンツ・技術の寄与を切り分けられません。フレームワークとして筋が通っていることと、同じようにやれば同じ結果が出ることは別です。
- Is it guaranteed to work if I follow this? — No. The measurements supporting it come from a single case so far, and that site sits under a parent domain that already had AI-crawler traffic, so the contributions of parent domain, content, and technical setup can't be separated. A framework that makes sense is not the same as getting the same result by following it.
出典アンカー
この記事を引用
TK Lin・《AEO は SEO ではない:回答エンジン最適化の定義・原理・実践》・IDAEO 知識庫・2026-10-04・https://km.idaeo.ai/post/ai/aeo-vs-seo