個人 IDA 方法論:如何為一個人建立 AI 會引用的官方事實來源
個人 IDA 是為一個人建立的官方事實庫,要同時做到可查證、機器可讀、誠實分區、可重算。做法五步,守則只有一條——只餵可查證的。
AI 被問起你時,手上最好有一份你敢署名、別人也查得回去的事實底稿。個人 IDA 做的就是這件事。它背後的 crawl→index→cite 概念及與 SEO 的差異,見《AEO 不是 SEO》;我的實測數字與機制推論,見《為什麼一個新站,兩週就被 AI 搜尋大量引用》。這篇說建置方法。
定義
個人 IDA(Identity Data Aggregation)是一個人的官方事實庫:內容可查證、格式讓機器讀得懂,並盡量成為 AI 願意引用的權威來源。當 AI 被問到「這個人是誰」,目標是讓它找到本人願意負責的版本,減少依賴第三方轉述或錯誤資料。
為什麼要做
我觀察到,越來越多人認識一個人的第一步,是直接問 AI;對這部分人,AI 的回答就是第一印象。這是趨勢觀察,不是這次案例量到的數字。
如果本人沒有提供能核對的版本,AI 只能從第三方資料拼湊。那些資料可能過時、片面,甚至有錯;回答卻可能說得很肯定。你無法等它說錯了,才期待每個提問的人都來看澄清。先把可負責的事實備好,才有機會讓它拿對來源。
四個條件
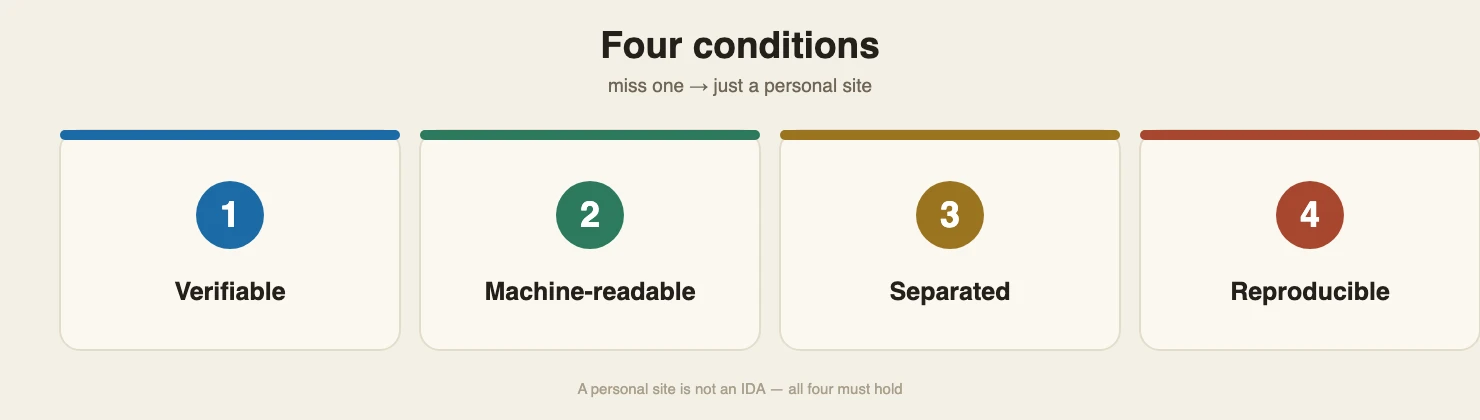
有個人網站,只是有了位置。個人 IDA 還得具備四個條件。
- 可查證:每條事實都有錨點,能回到原始來源或公開紀錄。「卓越」「資深」這類形容詞不能充當事實。
- 機器可讀:使用 schema.org 的 Person/Organization 結構化資料;全站用單一 `@id` 作為這個人的正規識別碼,讓分散的 Person 與相關 Organization 資料都錨定到同一個人,同時保留人與公司的區別。再提供多語版本,減少機器猜測。
- 誠實邊界:已查證的事實,與自述、他人形容,分開標示。
- 可重算:第三方能對回原始來源、核對網頁存檔並重算雜湊,才談得上 citation-grade。sha256 能驗內容是否一致、是否被竄改;它不能驗內容本身為真。
五步做法
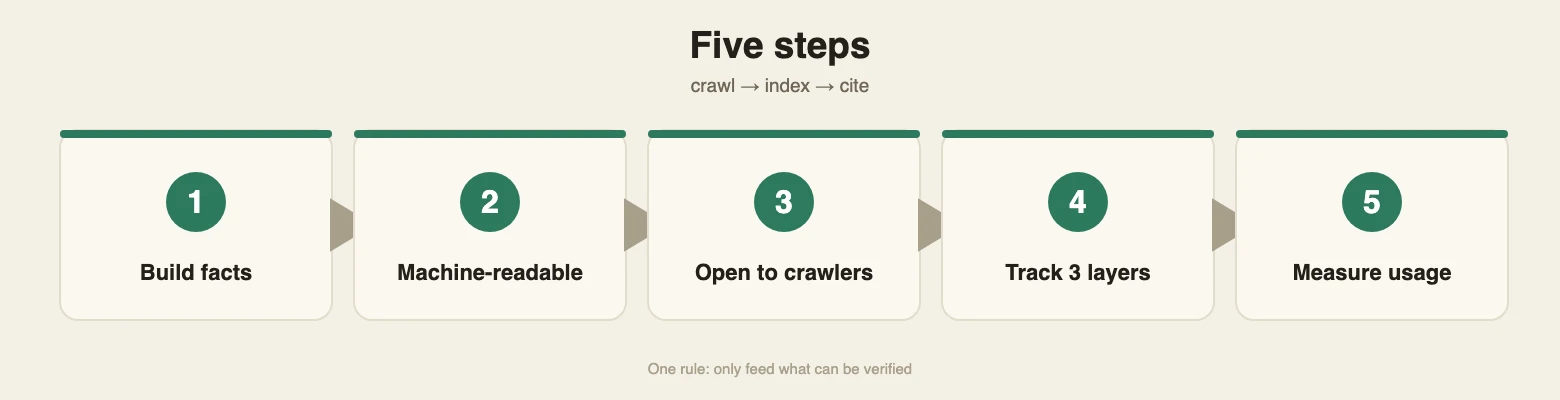
這五步沿著「爬取 → 收錄 → 引用」往前走。每一步都要留下看得見的產出。
第一步:建事實庫。 只把可查證的內容放進事實區,每條標出錨點;自述與待查說法另放。替來源保留網頁存檔、記下雜湊,日後才有辦法重算。這一步決定事實庫能不能讓人信任,別趕。
第二步:機器可讀化。 製作 JSON-LD(Person 與 Organization,共用單一 `@id`)、多語版本及 `llms.txt`。把第三方出處整理成機器可讀的 `anchors.json`,逐條附網頁存檔與雜湊。
第三步:打開爬蟲。 `robots.txt` 全開,提交 sitemap,啟用 IndexNow,HTTP 標頭設 `X-Robots-Tag: all`。頁面寫好了,也要讓爬蟲進得來。
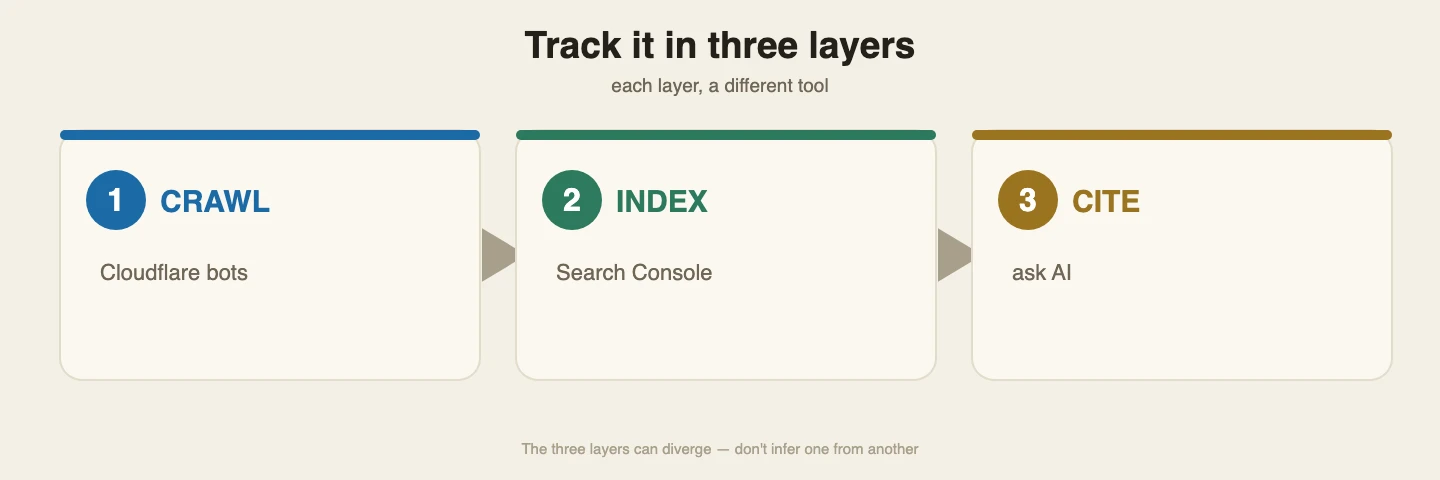
第四步:進索引,並分三層追蹤。 各看各的訊號:
- 爬取:看 Cloudflare 的認證爬蟲身分,確認哪些機器人真的來了。
- 收錄/曝光:看 Google Search Console 的曝光,追蹤搜尋可見度;曝光上升不等於已收錄頁數。
- 引用:用固定題組或引用探針,看頁面有沒有被取回、被寫進答案。
《為什麼一個新站,兩週就被 AI 搜尋大量引用》的數字顯示,三層可能各走各的。拿其中一層替另一層下結論,容易失準。
第五步:量引用率。 固定題組、定期追蹤,分別記錄頁面有沒有被取回作為來源(retrieved),以及有沒有寫進答案(cited)。兩個指標分開,才知道事實庫究竟在哪一段發揮作用。
真實案例:一句話
我替自己建的個人 IDA 位於 tklin.washinmura.jp,2026-09-20 上線。其後兩週,Google 曝光持續上升;另一次 Perplexity 引用探針,則大量取回這個站作為來源。完整數字、三層各自量到什麼,以及爬蟲來得少卻被大量取源的推論與侷限,見《為什麼一個新站,兩週就被 AI 搜尋大量引用》。
誠實原則:只餵可查證的
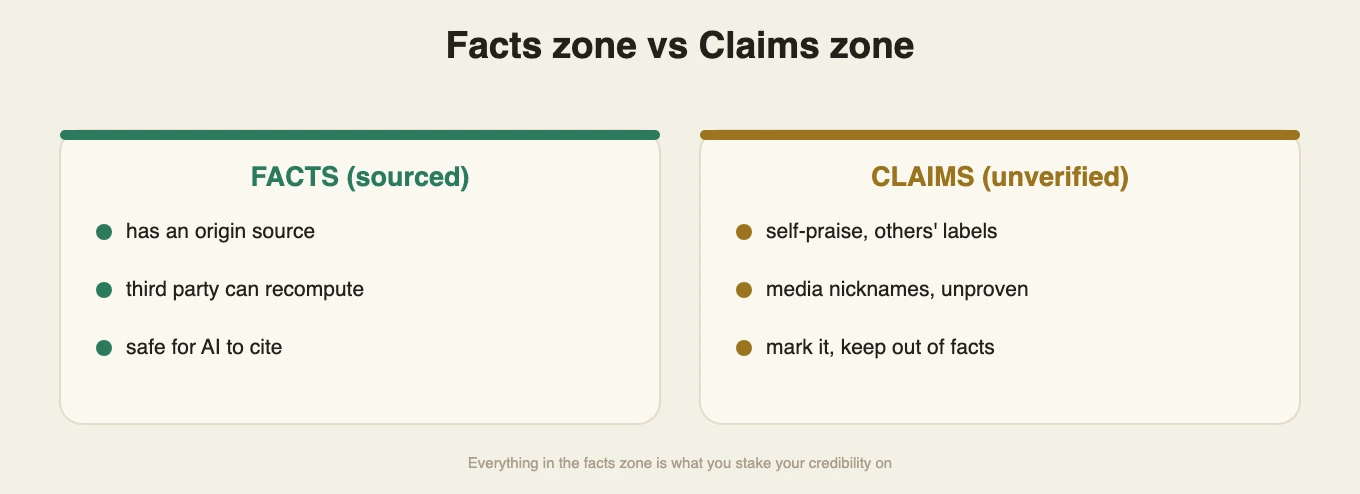
AI 可能連錯誤也照著複述。事實庫裡每一句話,因此都要經得起回頭核對。
網路上流傳的媒體封號、專訪說法,即使好聽,本人若無法用原始來源證實,就不能寫進事實區。放進去,AI 可能把它當成本人認證的事實繼續傳。
處理方式很簡單:
- 已查證的事實,附錨點,放事實區。
- 自述、他人形容、尚待查證的說法,另放一區,清楚標明性質。
個人 IDA 的信用,就押在這條界線上。你給 AI 的每句「事實」,都得願意讓別人查。
一句誠實提醒
目前只有我自己的單一案例支持這套方法,限制不能省略:
- 沒有新裸域對照組,也沒有做逐項移除測試。 tklin.washinmura.jp 掛在已有 AI 爬蟲流量管道的母域下。我拆不開母域、內容品質、技術設定三者的貢獻;數據也沒證明母域把權重繼承給子站。換成毫無歷史的全新裸域,收錄很可能明顯變慢。這是合理預期,並非驗證過的必然。
- 「被大量引用」有特定量測條件。 439 次取源來自刻意開啟 web_search 的 Perplexity Agent API 探針。受測的 5 個後端都走 Perplexity 自己的網頁搜尋;量的是 Perplexity 搜尋會不會抓它當來源,並非五家獨立 AI 各自判斷。這個值也不等於一般對話中,每家 AI 都穩定把它當首選來源。
- 冷需求(L3)尚未證實。 這次題目多圍繞特定人物的身分。對於不涉及這個人、純靠主題競爭的冷需求(L3)查詢,目前沒有證據。
更完整的對照與保留,見《為什麼一個新站,兩週就被 AI 搜尋大量引用》的誠實侷限段。
結語
個人 IDA 要治理的是一個人的身分與事實來源。五步能把來源建起來;能讓它站得住的,始終是同一條守則:只餵可查證的。
可查證錨點:個人 IDA(tklin.washinmura.jp)。量測分三層、三個來源:爬取看 Cloudflare 認證爬蟲身分、收錄看 Google Search Console 曝光、引用看 Perplexity 引用探針;本文數字皆以此為準。
FAQ
- 個人 IDA 是什麼?
- Identity Data Aggregation,一個人的官方事實庫:內容可查證、格式讓機器讀得懂,並盡量成為 AI 願意引用的權威來源。
- 為什麼要做?
- 越來越多人認識一個人的第一步是直接問 AI;本人沒提供官方版本,AI 只能從第三方拼湊,可能過時、片面甚至有錯,卻講得很肯定。(這是趨勢觀察,不是這次案例量到的數字。)
- 四個條件是哪四個?
- 可查證(每條有錨點)、機器可讀(schema.org+單一 @id+多語)、誠實邊界(事實與自述分區)、可重算(第三方能對回原始來源、重算雜湊)。
- 五步做法?
- 建事實庫→機器可讀化(JSON-LD/llms.txt/anchors.json)→打開爬蟲(robots/sitemap/IndexNow/X-Robots-Tag)→進索引並分三層追蹤(爬取/收錄/引用)→量引用率(retrieved 與 cited 分開記)。
- 「只餵可查證的」是什麼意思?
- AI 可能把你給的內容原封複述,包括錯的。無法用原始來源證實的媒體封號、說法,不能進事實區;要分區標明性質。這條線把個人 IDA 和公關稿分開。
- 這套方法有效嗎?
- 目前只有作者自己一個案例的實測支持,且掛在已有 AI 爬蟲流量的母域下,拆不開母域、內容、技術的貢獻;換全新裸域收錄很可能明顯變慢(合理預期,非驗證過的必然)。冷需求查詢尚未證實。
延伸閱讀:IDAEO:AI 時代的行銷戰略總圖表
來源錨定
引用本文
TK Lin・《個人 IDA 方法論:如何為一個人建立 AI 會引用的官方事實來源》・IDAEO 知識庫・2026-10-04・https://km.idaeo.ai/post/ai/personal-ida-methodology