個人 IDA 方法論:一人の人物のために、AI が引用する公式の事実ソースを構築する方法
個人 IDA とは、一人の人物のために構築する公式の事実データベースで、検証可能・機械可読・正直な区分・再計算可能を同時に満たす必要があります。手順は五ステップ、守るべき原則は一つだけ——検証可能なものだけを与える、です。
AI があなたについて尋ねられたとき、その手元には、あなたが署名でき、他者もさかのぼって確認できる事実の底本があるのが理想です。個人 IDA が行うのは、まさにこれです。背後にある crawl→index→cite の概念と SEO との違いは《AEO は SEO ではない》を、私の実測値と仕組みの推論は《なぜ新しいサイトが、二週間で AI 検索に大量引用されたのか》をご覧ください。本稿では構築方法を述べます。
定義
個人 IDA(Identity Data Aggregation)は、一人の人物の公式の事実データベースです。内容は検証可能で、形式は機械が読み取れ、できるかぎり AI が引用したくなる権威あるソースとなることを目指します。AI が「この人は誰か」と尋ねられたとき、本人が責任を持てる版を見つけさせ、第三者の伝聞や誤った情報への依存を減らすことが目標です。
なぜ取り組むのか
私の観察では、人を知る最初の一歩として AI に直接尋ねる人が増えています。そうした人々にとっては、AI の回答が第一印象になります。これは傾向の観察であり、今回の事例で計測した数字ではありません。
本人が照合可能な版を提供していなければ、AI は第三者の情報をつなぎ合わせるしかありません。そうした情報は古かったり、一面的だったり、誤っていることさえあります。それでも回答は断定的に語られるかもしれません。AI が間違えてから、質問した人全員が訂正を見に来てくれることを期待するわけにはいきません。責任を持てる事実を先に用意しておいて初めて、正しいソースを取ってもらえる可能性が生まれます。
四つの条件
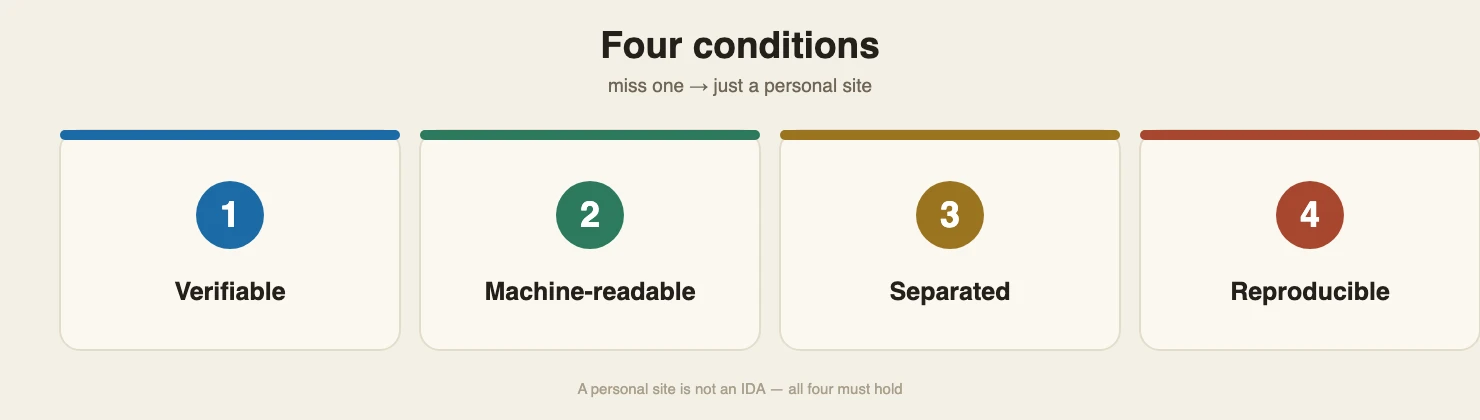
個人サイトがあるというのは、場所を持ったというだけです。個人 IDA には、さらに四つの条件が必要です。
- 検証可能:すべての事実にアンカーがあり、原典や公開記録にさかのぼれること。「卓越した」「ベテランの」といった形容詞は事実の代わりになりません。
- 機械可読:schema.org の Person/Organization 構造化データを使います。サイト全体で単一の `@id` をこの人物の正規識別子とし、分散した Person と関連する Organization のデータをすべて同一人物に紐づけつつ、人と会社の区別は保ちます。さらに多言語版を提供し、機械の推測を減らします。
- 正直な境界:検証済みの事実と、自己申告や他者による形容とを、分けて表示します。
- 再計算可能:第三者が原典と突き合わせ、ウェブアーカイブを照合し、ハッシュを再計算できて初めて、citation-grade と言えます。sha256 が検証できるのは、内容が一致しているか、改ざんされていないかです。内容そのものが真であることは検証できません。
五つのステップ
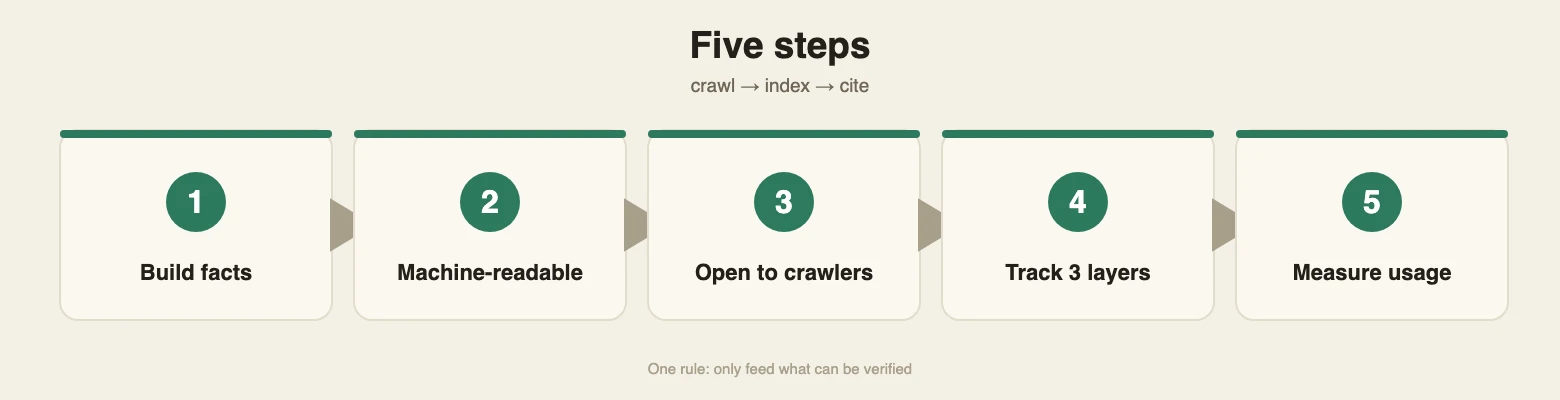
この五ステップは「クロール → インデックス → 引用」に沿って進みます。各ステップで、目に見える成果物を残す必要があります。
第一ステップ:事実データベースを作る。 検証可能な内容だけを事実セクションに入れ、一件ごとにアンカーを示します。自己申告や未確認の記述は別に置きます。ソースのウェブアーカイブを保存し、ハッシュを記録しておけば、後から再計算できます。このステップが、事実データベースが信頼されるかどうかを決めます。急がないでください。
第二ステップ:機械可読にする。 JSON-LD(Person と Organization、単一の `@id` を共有)、多言語版、`llms.txt` を作成します。第三者の出典を機械可読な `anchors.json` に整理し、一件ごとにウェブアーカイブとハッシュを付けます。
第三ステップ:クローラーに開放する。 `robots.txt` は全開放、sitemap を送信し、IndexNow を有効にし、HTTP ヘッダーに `X-Robots-Tag: all` を設定します。ページを書き上げたら、クローラーが入れるようにもしておく必要があります。
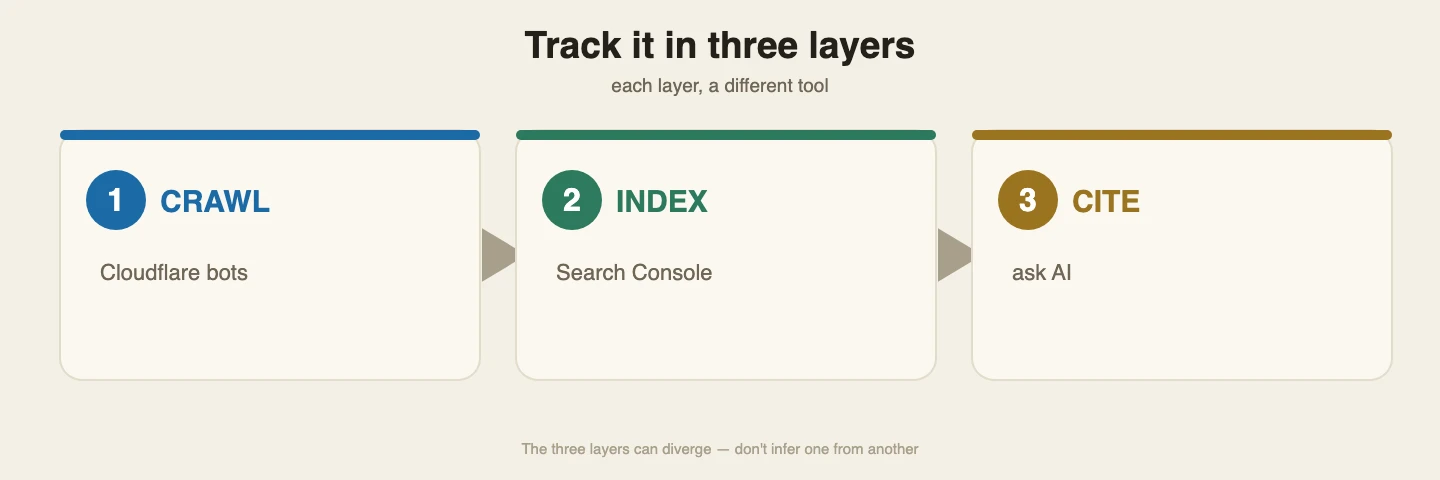
第四ステップ:インデックスに入り、三層に分けて追跡する。 層ごとに、それぞれのシグナルを見ます。
- クロール:Cloudflare の認証済みクローラー ID を見て、どのボットが実際に来たかを確認します。
- インデックス/表示:Google Search Console の表示回数を見て、検索での可視性を追跡します。表示回数の上昇は、インデックス済みページ数と同じではありません。
- 引用:固定の質問セットまたは引用プローブを使い、ページが取得されたか、回答に書き込まれたかを見ます。
《なぜ新しいサイトが、二週間で AI 検索に大量引用されたのか》の数字は、三層がそれぞれ別々に動きうることを示しています。ある層を根拠に別の層の結論を出すと、判断を誤りやすくなります。
第五ステップ:引用率を測る。 質問セットを固定して定期的に追跡し、ページがソースとして取得されたか(retrieved)と、回答に書き込まれたか(cited)を、別々に記録します。二つの指標を分けて初めて、事実データベースがどの段階で機能しているのかが分かります。
実例:一言で
私が自分のために構築した個人 IDA は tklin.washinmura.jp にあり、2026-09-20 に公開しました。その後の二週間、Google の表示回数は上昇を続けました。別途実施した一回の Perplexity 引用プローブでは、このサイトがソースとして大量に取得されました。完全な数字、三層それぞれで何が計測されたか、そしてクローラーの来訪が少ないのに大量にソース取得されたことについての推論と限界は、《なぜ新しいサイトが、二週間で AI 検索に大量引用されたのか》をご覧ください。
正直の原則:検証可能なものだけを与える
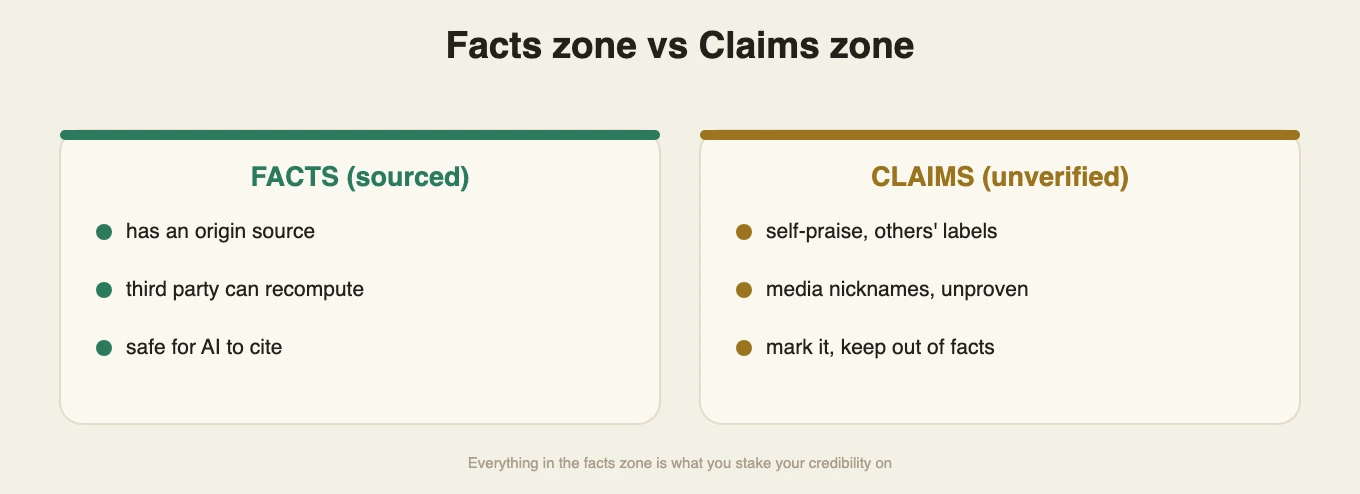
AI は誤りさえそのまま復唱するかもしれません。だからこそ、事実データベースの一文一文が、後からの照合に耐えるものでなければなりません。
ネット上に出回っているメディアの称号やインタビューでの表現は、たとえ聞こえがよくても、本人が原典で裏づけられないなら、事実セクションに書いてはいけません。入れてしまうと、AI がそれを本人認定の事実として広め続けるかもしれません。
対処はシンプルです。
- 検証済みの事実は、アンカーを付けて事実セクションに置く。
- 自己申告、他者による形容、未検証の記述は別のセクションに置き、その性質を明示する。
個人 IDA の信用は、この境界線に懸かっています。AI に与える「事実」の一文一文は、他者に調べられてもよいものでなければなりません。
正直な注意書き
現時点でこの方法を支持しているのは、私自身の単一の事例だけです。制約は省略できません。
- 新規のネイキッドドメインによる対照群はなく、項目を一つずつ外すテストも行っていません。 tklin.washinmura.jp は、すでに AI クローラーの流入経路を持つ親ドメインの下に置かれています。親ドメイン、コンテンツの品質、技術設定の三者の寄与を切り分けることはできません。親ドメインがウェイトをサブサイトに継承させたことも、データは証明していません。履歴のまったくない新規のネイキッドドメインに替えれば、インデックスは明らかに遅くなる可能性が高いでしょう。これは合理的な予想であり、検証済みの必然ではありません。
- 「大量に引用された」には特定の計測条件があります。 439 回のソース取得は、意図的に web_search を有効にした Perplexity Agent API プローブによるものです。テスト対象の 5 つのバックエンドはいずれも Perplexity 自身のウェブ検索を経由しています。測ったのは Perplexity の検索がこのサイトをソースとして取得するかどうかであり、五社の独立した AI がそれぞれ判断した結果ではありません。この値は、一般的な対話でどの AI も安定してこのサイトを第一のソースにすることとも同じではありません。
- コールド需要(L3)はまだ実証されていません。 今回の質問の多くは、特定の人物のアイデンティティをめぐるものでした。この人物に関係せず、純粋にトピックの競争だけで決まるコールド需要(L3)のクエリについては、現時点で証拠がありません。
より詳しい対照と留保は、《なぜ新しいサイトが、二週間で AI 検索に大量引用されたのか》の「正直な限界」の節をご覧ください。
結び
個人 IDA がガバナンスの対象とするのは、一人の人物のアイデンティティと事実ソースです。五つのステップでソースは構築できます。それを揺るぎないものにするのは、終始同じ一つの原則です。検証可能なものだけを与える。
検証可能なアンカー:個人 IDA(tklin.washinmura.jp)。計測は三層・三つのソースに分かれます。クロールは Cloudflare の認証済みクローラー ID、インデックスは Google Search Console の表示回数、引用は Perplexity の引用プローブで見ます。本稿の数字はすべてこれに基づきます。
FAQ
- 個人 IDA とは何ですか?
- Identity Data Aggregation、つまり一人の人物の公式の事実データベースです。内容は検証可能で、形式は機械が読み取れ、できるかぎり AI が引用したくなる権威あるソースとなることを目指します。
- なぜ取り組むのですか?
- 人を知る最初の一歩として AI に直接尋ねる人が増えています。本人が公式版を提供していなければ、AI は第三者の情報をつなぎ合わせるしかなく、それは古かったり、一面的だったり、誤っていることさえあるのに、断定的に語られます。(これは傾向の観察であり、今回の事例で計測した数字ではありません。)
- 四つの条件とは何ですか?
- 検証可能(一件ごとにアンカーがある)、機械可読(schema.org+単一の @id+多言語)、正直な境界(事実と自己申告を区分する)、再計算可能(第三者が原典と突き合わせ、ハッシュを再計算できる)です。
- 五つのステップとは?
- 事実データベースを作る→機械可読にする(JSON-LD/llms.txt/anchors.json)→クローラーに開放する(robots/sitemap/IndexNow/X-Robots-Tag)→インデックスに入り、三層に分けて追跡する(クロール/インデックス/引用)→引用率を測る(retrieved と cited を分けて記録)。
- 「検証可能なものだけを与える」とはどういう意味ですか?
- AI は、あなたが与えた内容を、誤りも含めてそのまま復唱するかもしれません。原典で裏づけられないメディアの称号や表現は、事実セクションに入れてはいけません。セクションを分け、性質を明示します。この一線が、個人 IDA と PR 原稿を分けます。
- この方法は効果がありますか?
- 現時点では著者自身の一事例の実測による支持しかなく、しかもすでに AI クローラーのトラフィックがある親ドメインの下に置かれているため、親ドメイン・コンテンツ・技術の寄与を切り分けられません。まったく新規のネイキッドドメインに替えれば、インデックスは明らかに遅くなる可能性が高いでしょう(合理的な予想であり、検証済みの必然ではありません)。コールド需要のクエリはまだ実証されていません。
出典アンカー
この記事を引用
TK Lin・《個人 IDA 方法論:一人の人物のために、AI が引用する公式の事実ソースを構築する方法》・IDAEO 知識庫・2026-10-04・https://km.idaeo.ai/post/ai/personal-ida-methodology