AEO 不是 SEO:答案引擎优化的定义、原理与做法
AEO 是让 AI 回答时引用你“可查证的官方版本”的工作,本质是身份与事实来源治理,不是关键词排名。SEO 看排名与点击,AEO 看 AI 有没有用你、用得对不对。
有人点进你的网站,和 AI 拿你的内容回答,是两种成绩。这篇谈 AEO 的定义、它和 SEO 的差别,以及我怎么理解背后的原理。实测数字与机制拆解,见《为什么一个新站,两周就被 AI 搜索大量引用》;搭建方法,见《个人 IDA 方法论》。
定义
AEO(Answer Engine Optimization,答案引擎优化)是让 AI 回答问题时,引用你“可查证的官方版本”作为来源的工作;核心是身份与事实来源治理,不是关键词排名。
重点有三个。目标是 AI 的回答;来源应是你愿意负责的官方版本;你要处理的是“谁是谁、哪些事实查得到”,而非词频。
所以,AEO 要问的不是“我排第几”,而是 AI 替我说话时,拿到的资料对不对、能不能查。
与 SEO 的差异
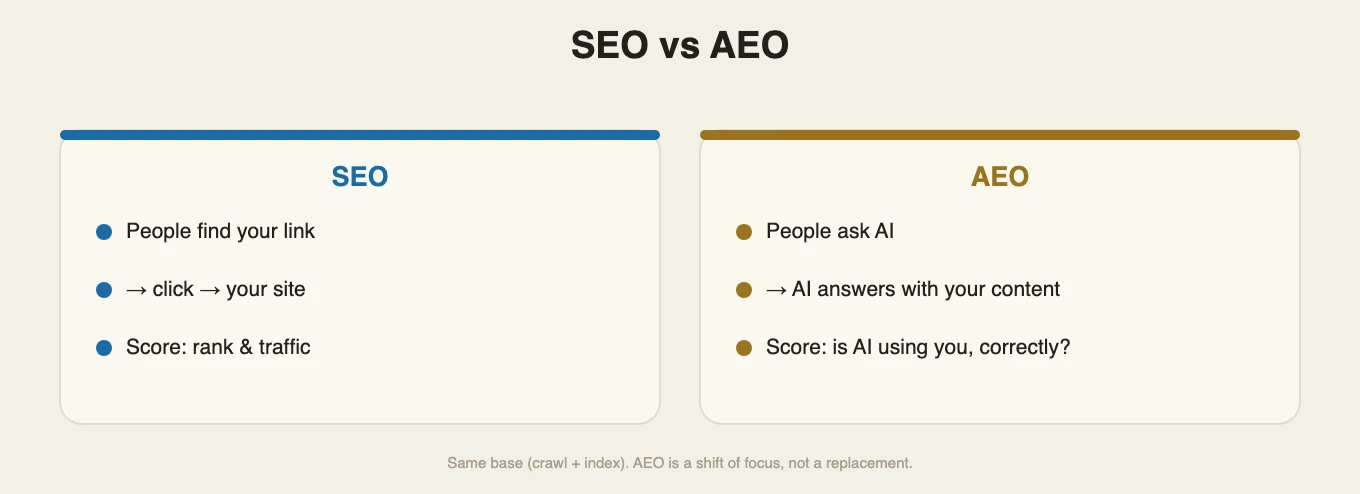
SEO 长年重视链接能否被找到、被点开,成果主要看排名与流量。AEO 追的是另一段路:用户可能一次都没点进来,AI 已在对话或 agent 流程中取用了你的内容。这时要量的是它有没有用,以及用得对不对。
两者都得先过“能被爬、能被收录”这一关。AEO 接着问:AI 取用时,抓到的是不是你认可、而且查得证的版本。
想象一个页面几乎没有点击,却进了 AI 的回答。用流量记分,它不起眼;用来源取用记分,它有作用。这只是说明两套记分板的示意,不是我量到的逐日数据。我手上的引用探针只有一次截面,不能宣称它“天天被引用”。
原理:crawl → index → cite
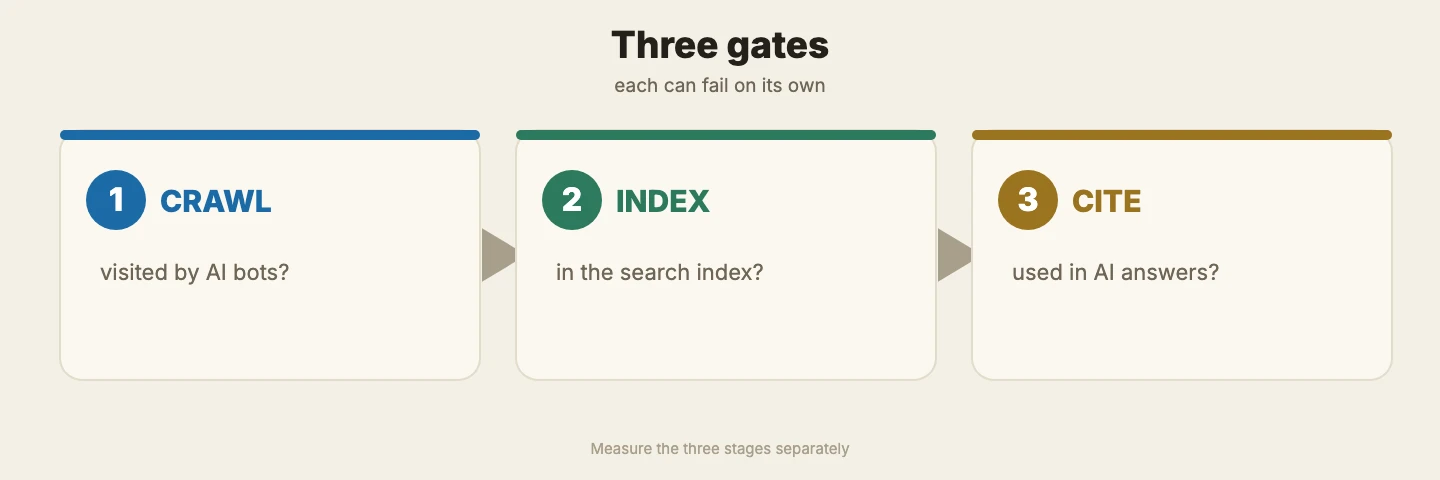
我把内容进入 AI 回答的路径拆成三段:
- crawl(被爬):爬虫有没有抓到页面。
- index(被收录):搜索索引有没有收进去。
- cite(被引用):AI 回答有没有拿它当来源。
三段都要量。被爬不保证被收录;被收录也不保证被引用。我的案例甚至出现一家爬虫只来极少次,页面却在它的搜索探针里被大量取源。
对那次 Perplexity 探针,一个合理推论是:Perplexity 这类 meta-search 的实时检索搭了通用搜索索引的便车,并非只靠自家爬虫建库。这只解释 Perplexity 的这一次观察,不能推到所有 AI 搜索。有些引擎很依赖自家专用爬虫,通用搜索与专用爬虫都不该挡。数字与反例,见《为什么一个新站,两周就被 AI 搜索大量引用》。
只看爬虫日志会错估引用;只看收录,也不知道最后有没有被用。crawl、index、cite 各有自己的账。
什么让一份内容“可被引用”
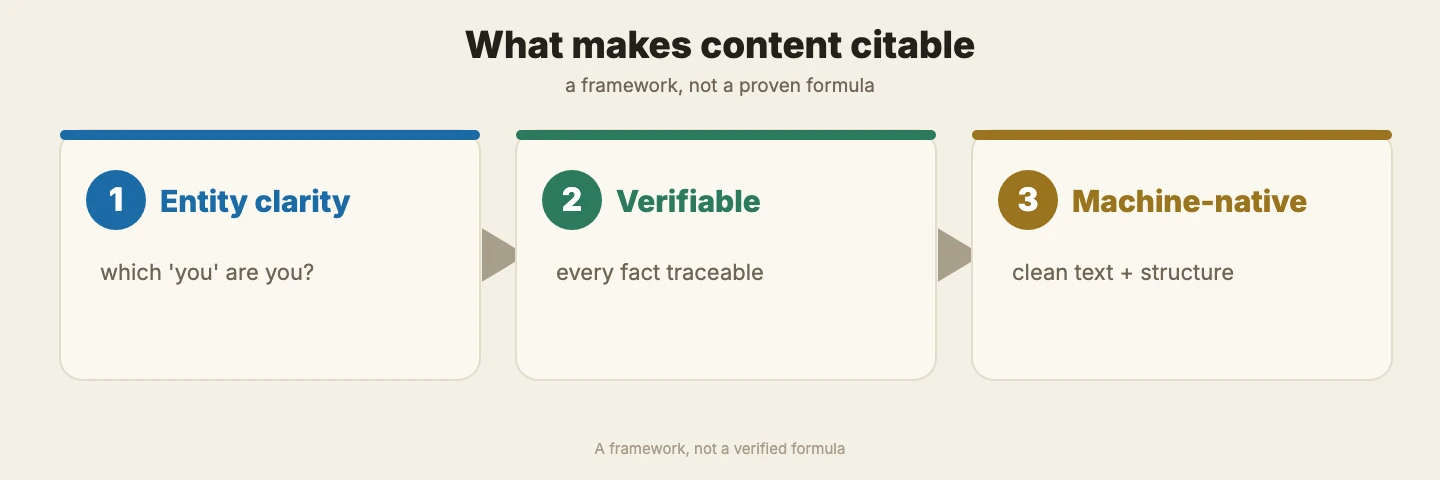
我用三根支柱整理这件事。它们是思考框架,不是已证明的充要公式。
- 实体消歧:先让机器知道“你是哪一个你”。同名的人、新旧网站、不同语言版本若被混成一团,回答就容易漏掉你,或引错人。跨站、跨语言指向同一个规范身份,能减少这种猜测。
- 可查证的证据链:事实要能逐条回到原始来源或公开记录,让第三方自行核对、重算。只写“我说我是”,撑不起需要引用的答案。
- AI 原生文本:提供结构化数据与干净的纯文本版本,让机器容易解析、取用。给人看的排版与给机器读的结构,可以各司其职。
在这个框架里,我把“消歧 × 查证 × 机器可读”视为可能共同影响取源的条件;少一项,可能就弱一分。但我没有做逐项移除测试,不能证明各项效果,更不能把它写成公式。机制假设见《为什么一个新站,两周就被 AI 搜索大量引用》;单一 `@id` 的 schema.org、锚点清单、llms.txt 系列、爬虫配置与三源测量怎么做,见《个人 IDA 方法论》的四条件与五步做法。
诚实局限
这套说法目前只得到一个案例支持,还不是经多案例验证的定律。那个站挂在已有 AI 爬虫流量渠道的母域下;我没有新裸域对照组,也没有做逐项移除测试,拆不开母域、内容与技术配置各自的贡献。它搭上了母域既有流量,但数据没有证明母域把“权重”继承给子站。
“被大量引用”来自开启 web_search 的 Perplexity Agent API 探针。受测的 5 个后端走的都是 Perplexity 自己的网页搜索;量到的是 Perplexity 搜索会不会抓它当来源,并非五家独立 AI 各自判断。这也不等于一般对话里,各家 AI 都会稳定首引它。
冷需求(L3,也就是不涉及这个人、纯靠主题竞争的查询)尚未证实。更完整的测量条件与保留,见《为什么一个新站,两周就被 AI 搜索大量引用》的诚实局限段。框架能解释眼前的数据,还不能保证照做就有相同结果。
一句话总结
SEO 让人找到你的链接;AEO 要让 AI 用你能负责的版本回答。要知道自己做到了哪一步,就把 crawl、index、cite 分开量。
FAQ
- AEO 和 SEO 一样吗?
- 不一样,但不互斥。SEO 看排名与流量,AEO 看 AI 取用你的内容为答案、用得对不对。两者共用同一套地基:能被爬、能被收录;AEO 在这之上多问一件事——AI 抓到的是不是你认可、而且查得证的版本。
- AEO 的中文是什么?
- 答案引擎优化(Answer Engine Optimization)。优化的对象是 AI 回答时手上的资料是不是你认可、查得证的版本,不是搜索排名。
- 几乎没有点击的页面有意义吗?
- 可能有。一个页面可以几乎没有点击,却在 AI 回答时被当成来源。在 SEO 记分板上它不起眼,在 AEO 记分板上它有作用。这是说明两套记分板不同的示意,不是逐日数据。
- crawl、index、cite 是什么?
- 内容进入 AI 回答的三段:被爬、被收录、被引用。它们不会自动相连,每一段都可能独立失败;要各自量、各自报,不能合并成一个总分。
- 什么让一份内容“可被引用”?
- 概念上靠三件治理工作:实体消歧、可查证的证据链、AI 原生文本。这是思考框架,不是已证明的充要公式。
- 照这套做就一定有效吗?
- 不保证。支持它的实测目前只有单一案例,且挂在已有 AI 爬虫流量的母域下,拆不开母域、内容、技术的贡献。框架讲得通,不等于照做就有相同结果。
延伸阅读:IDAEO:AI 时代的营销战略总图表
来源锚定
引用本文
TK Lin・《AEO 不是 SEO:答案引擎优化的定义、原理与做法》・IDAEO 知識庫・2026-10-04・https://km.idaeo.ai/post/ai/aeo-vs-seo